1文章進階EN
Measuring Human Performance on ARC-AGI-3
發布 ARC-AGI-3 系列中 135 個抽象推理環境的完整人類測試資料集,包含 458 名參與者的實測記錄與步驟重放。資料顯示所有環境均可由人類在無預先訓練下解決,並提供效率分數與評分機制更新,讓研究者能分析人類學習與適應新問題的能力。
部落格 ・ 國際 ・ 英文 ・ A 級 ・ 7 筆內容 ・ 最近更新 2026/09/03
ARC-AGI 基準的官方分析:新模型在 ARC-AGI-3 上的表現與成本、人類基準怎麼量
依人氣
發布 ARC-AGI-3 系列中 135 個抽象推理環境的完整人類測試資料集,包含 458 名參與者的實測記錄與步驟重放。資料顯示所有環境均可由人類在無預先訓練下解決,並提供效率分數與評分機制更新,讓研究者能分析人類學習與適應新問題的能力。
ARC Prize Foundation 正式推出「ARC Prize Verified」計畫,透過獨立學術小組審核與使用隱藏測試集,確保 ARC-AGI 評測分數的嚴謹與可信度。
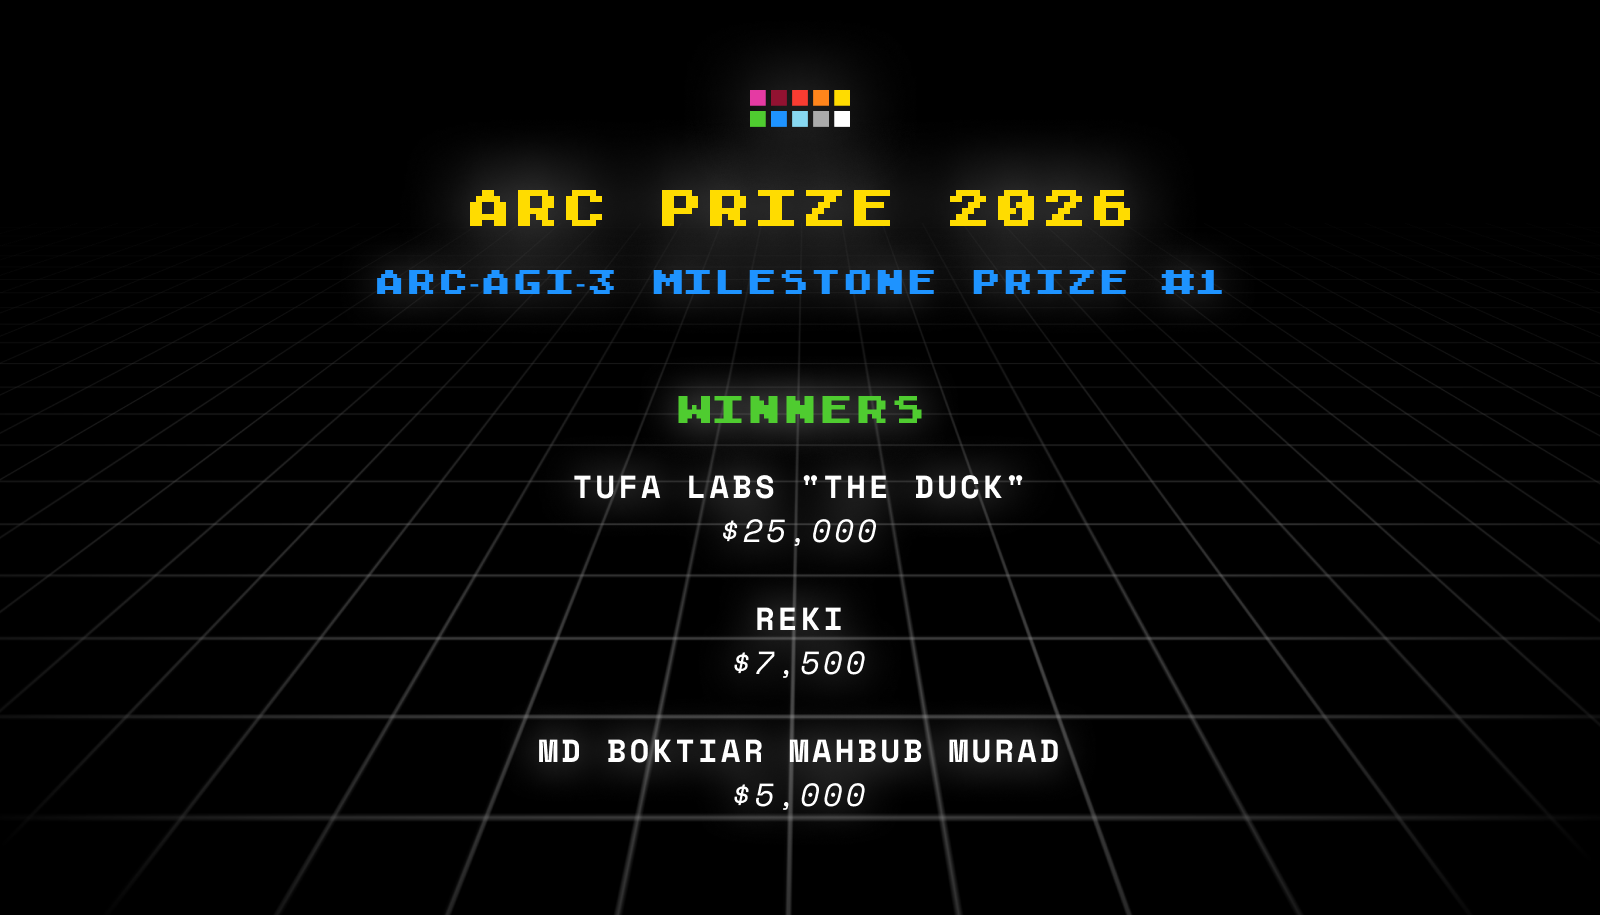
介紹 ARC Prize 2026 首個里程碑獎項的獲獎作品,展示三種不同策略的 AI 代理如何解決複雜遊戲任務。讀者可了解將視覺輸入轉為程式碼執行、或透過視覺語言模型直接決策的具體做法,並學習如何最佳化本地部署的 AI 系統。
ARC Prize 2025 公佈競賽結果與論文獎項,總計 1,455 支隊伍參賽,最高分達 24%。文章深入分析「 refinement loop(最佳化迴圈)」如何成為推動 AGI 的關鍵,並介紹 Tiny Recursive…
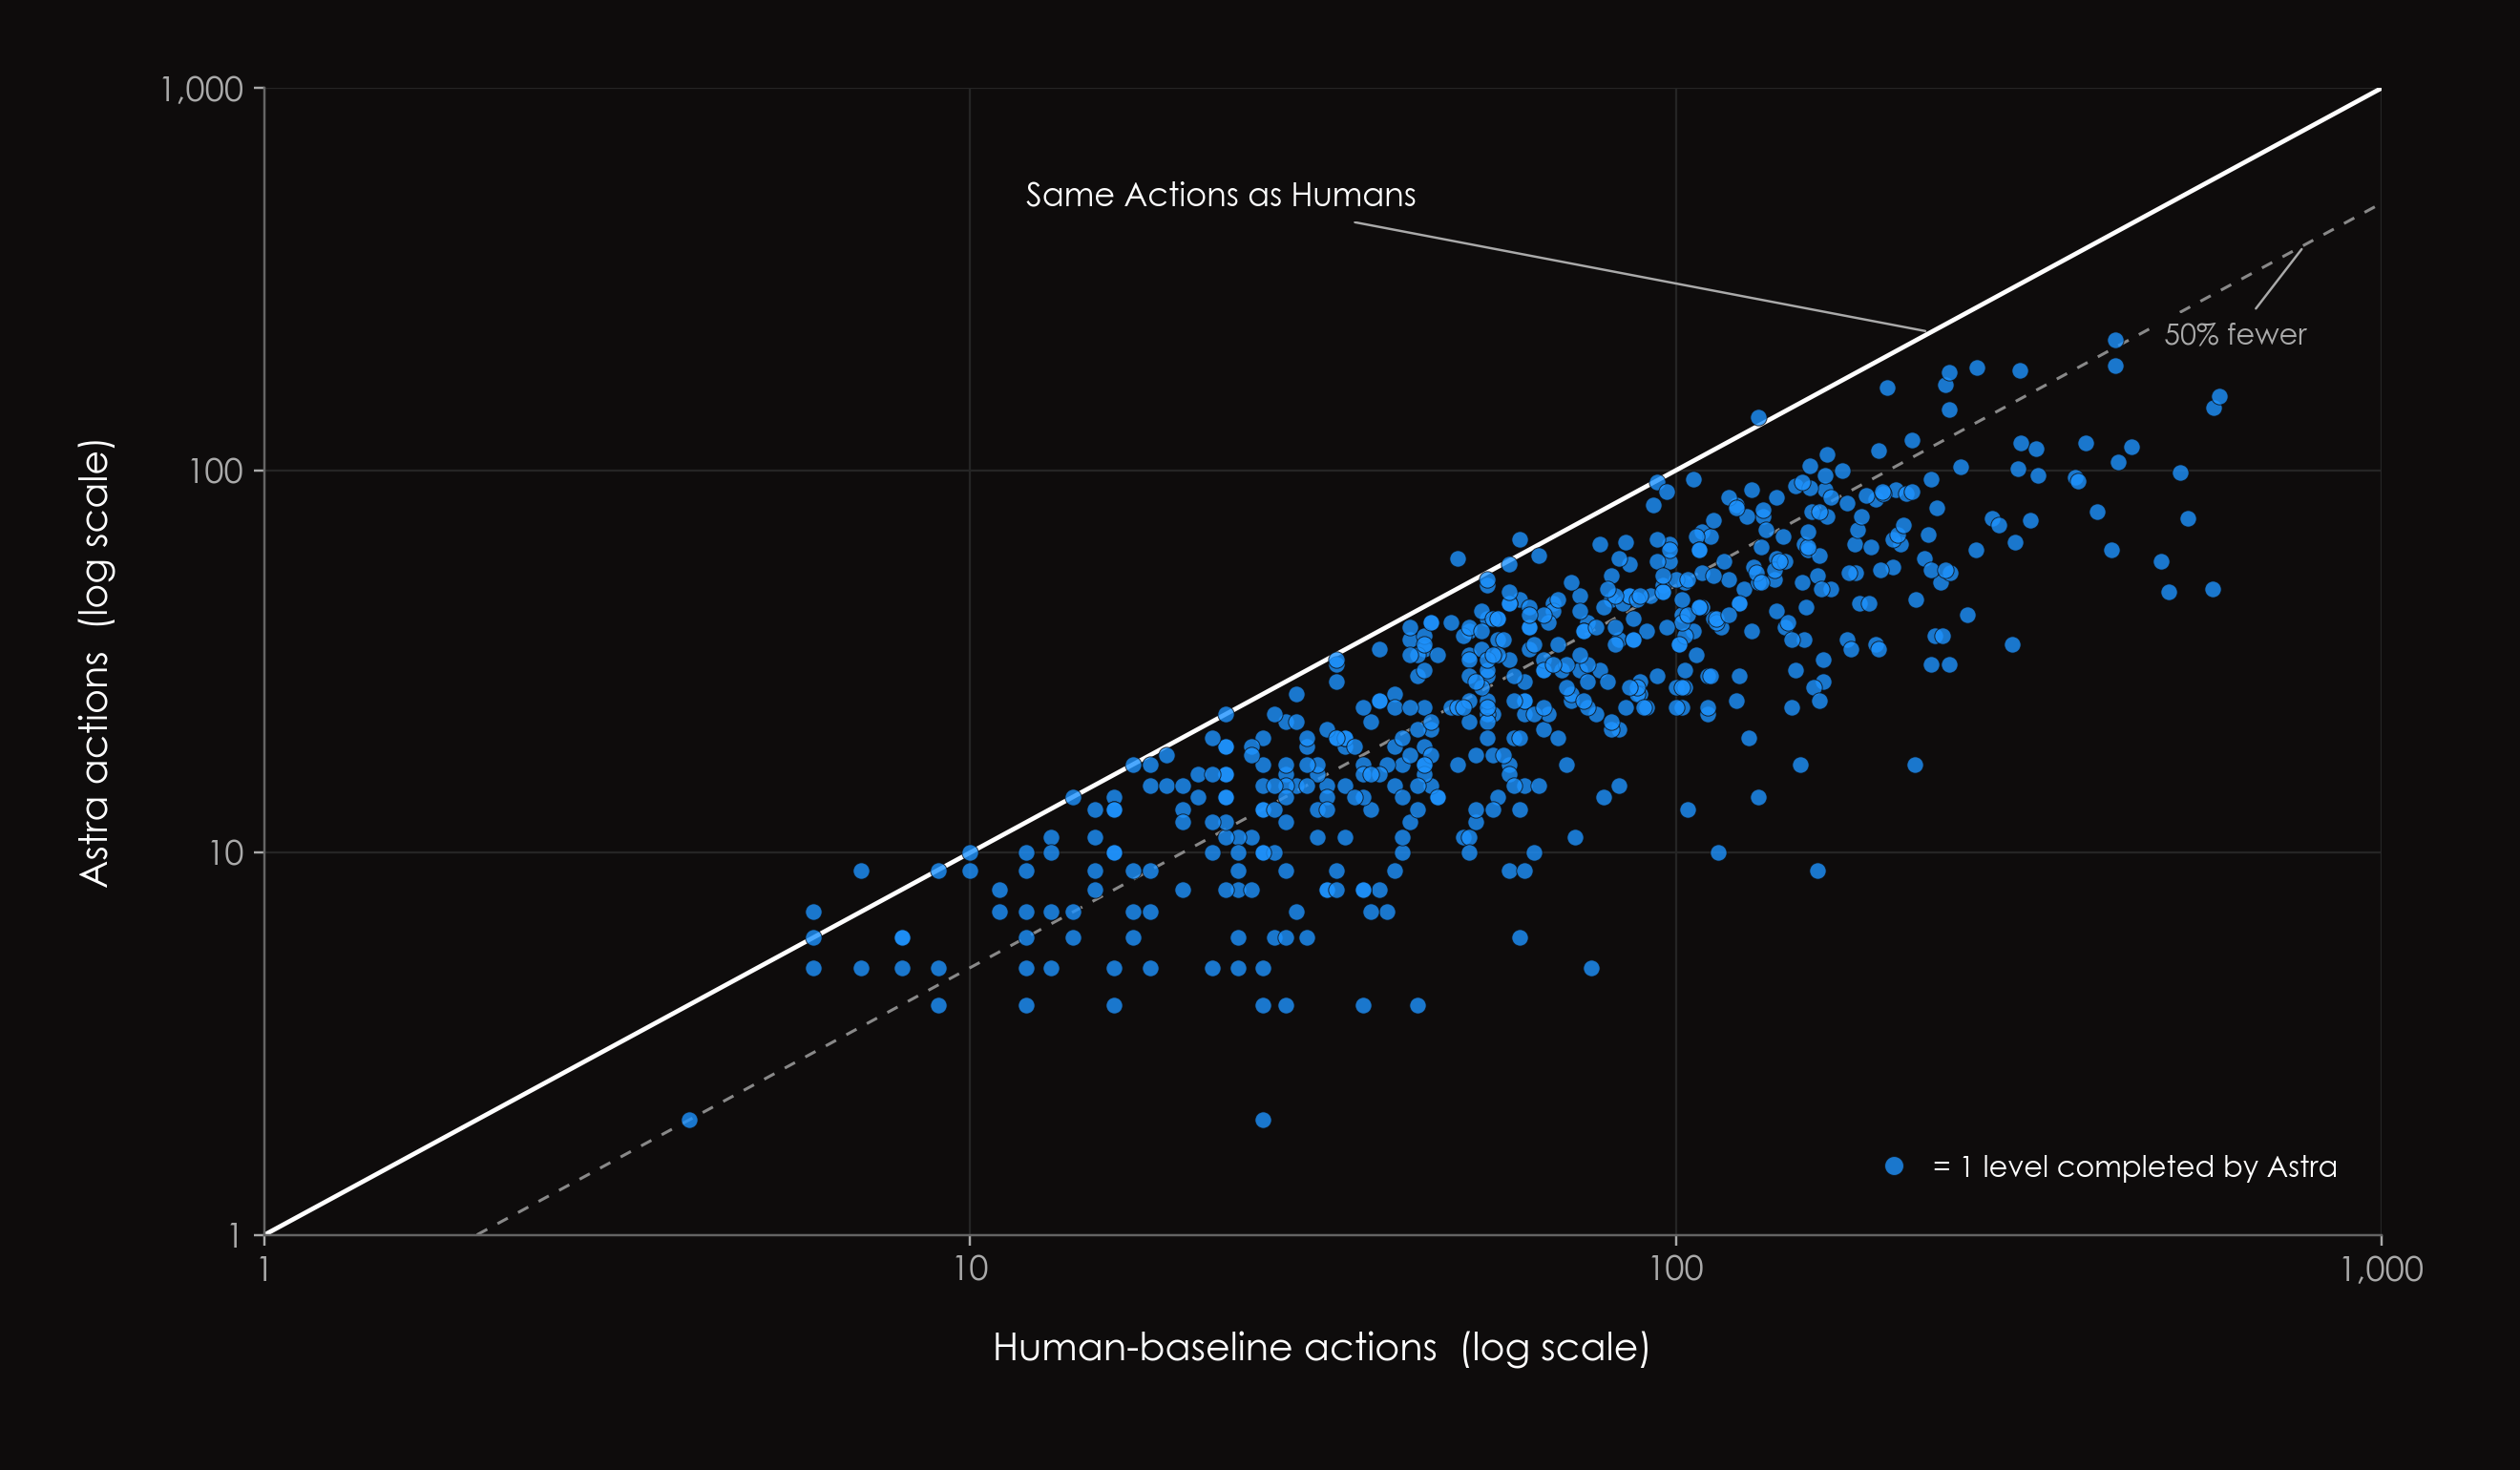
OpenAI 的 GPT-6 Astra 在 ARC-AGI-3 測試中達成最優成績,展現超越人類基準的行動效率與環境建模能力。文章分析其如何透過自訂符號語言與工具庫解決複雜任務,並比較不同推理層級的成本效益。
分析 OpenAI 的 GPT-5.5 與 Anthropic 的 Opus 4.7 在 ARC-AGI-3 測試環境中的推理過程,發現了模型常見的三種失敗模式,包括無法建立全域性世界模型、錯誤抽象訓練資料以及解決單一關卡卻未學習遊戲規則。
依發布時間
OpenAI 的 GPT-6 Astra 在 ARC-AGI-3 測試中達成最優成績,展現超越人類基準的行動效率與環境建模能力。文章分析其如何透過自訂符號語言與工具庫解決複雜任務,並比較不同推理層級的成本效益。
介紹 ARC Prize 2026 首個里程碑獎項的獲獎作品,展示三種不同策略的 AI 代理如何解決複雜遊戲任務。讀者可了解將視覺輸入轉為程式碼執行、或透過視覺語言模型直接決策的具體做法,並學習如何最佳化本地部署的 AI 系統。
分析 OpenAI 的 GPT-5.5 與 Anthropic 的 Opus 4.7 在 ARC-AGI-3 測試環境中的推理過程,發現了模型常見的三種失敗模式,包括無法建立全域性世界模型、錯誤抽象訓練資料以及解決單一關卡卻未學習遊戲規則。
發布 ARC-AGI-3 系列中 135 個抽象推理環境的完整人類測試資料集,包含 458 名參與者的實測記錄與步驟重放。資料顯示所有環境均可由人類在無預先訓練下解決,並提供效率分數與評分機制更新,讓研究者能分析人類學習與適應新問題的能力。
ARC Prize 2025 公佈競賽結果與論文獎項,總計 1,455 支隊伍參賽,最高分達 24%。文章深入分析「 refinement loop(最佳化迴圈)」如何成為推動 AGI 的關鍵,並介紹 Tiny Recursive…
ARC Prize Foundation 正式推出「ARC Prize Verified」計畫,透過獨立學術小組審核與使用隱藏測試集,確保 ARC-AGI 評測分數的嚴謹與可信度。