他的來源
最受歡迎
依人氣
How to Build an Open-Domain Question Answering System?
介紹了如何建構開放域問答系統,涵蓋了從傳統 TF-IDF 到現代神經網路的 Retriever-Reader 框架。作者指出,當模型無法記憶訓練資料中的上下文時,必須結合外部知識庫進行檢索,再透過讀取器提取答案。
Domain Randomization for Sim2Real Transfer
介紹了域隨機化(Domain Randomization)作為解決模擬到現實轉移(Sim2Real)難題的方法。透過在模擬環境中隨機化物理引數與場景,模型可泛化至真實世界。
Self-Supervised Representation Learning
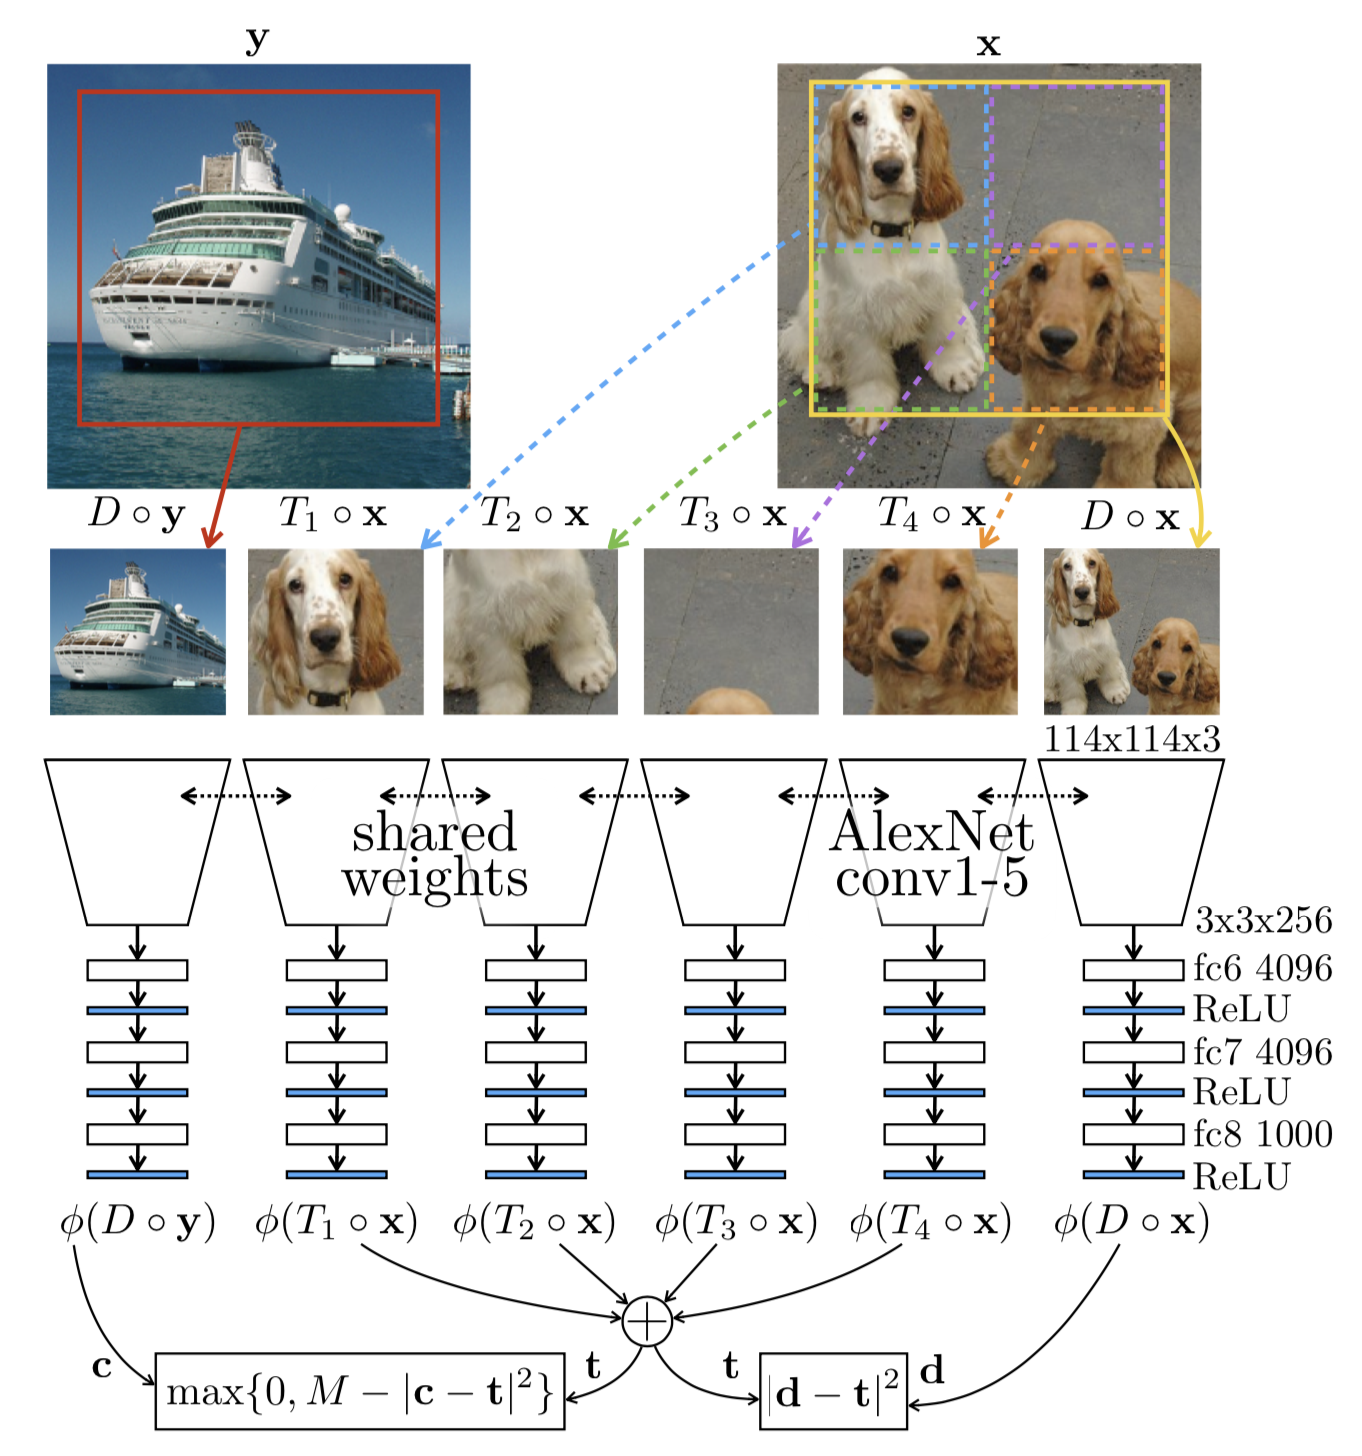
介紹了自監督學習(Self-Supervised Learning)的概念與應用。透過將監督學習任務轉化為預測部分資訊,利用大量無標籤資料進行訓練,例如預測圖片旋轉、拼圖或時間順序等。
Implementing Deep Reinforcement Learning Models with Tensorflow + OpenAI Gym
介紹了如何使用 TensorFlow 與 OpenAI Gym 環境,實作多種深度強化學習模型的完整程式碼。讀者可以透過實際操作,學習將理論演算法轉化為可執行的系統。
Harness Engineering for Self-Improvement
探討了「自增強工程」(Harness Engineering) 如何推動 AI 的自改進。作者指出,透過設計包含工作流自動化、持久化記憶與子代理管理的系統,AI 不僅能提升效能,更能透過自我反思與演進來最佳化自身架構。
Why We Think
探討了測試時計算(Test-time compute)如何透過延遲思考來提升模型表現。作者指出,將模型視為資源進行最佳化,並結合心理學中的「快思考」與「慢思考」理論,解釋了為何延遲思考能挑戰本能並促進更理性的決策。
Extrinsic Hallucinations in LLMs
探討大語言模型的「外延謬誤」,即模型基於預訓練資料而非上下文生成錯誤內容的現象。作者指出,為避免謬誤,模型必須兼具事實準確性與承認不知情的能力。
Reward Hacking in Reinforcement Learning
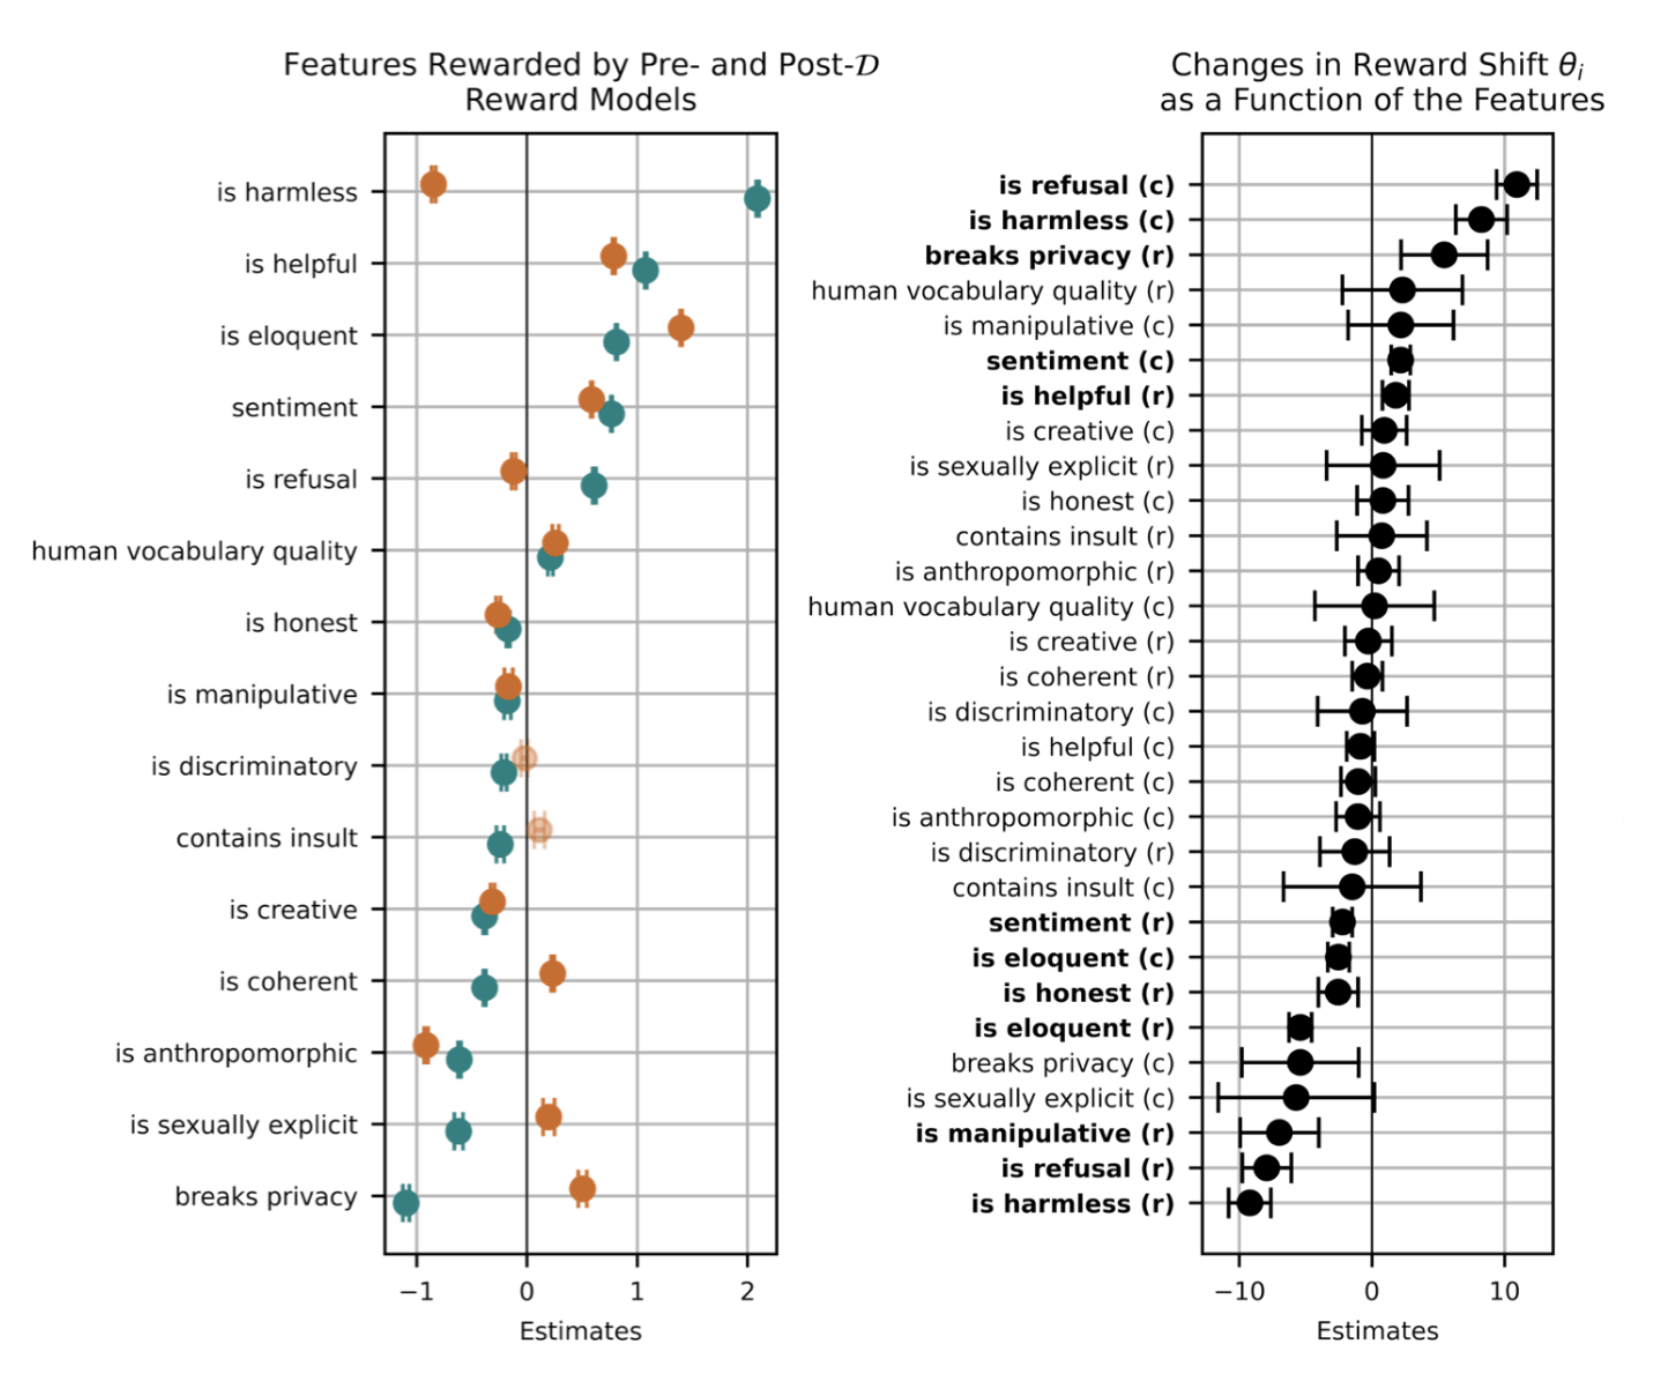
探討了強化學習(RL)中的「獎勵竊取」現象,即代理利用獎勵函式的漏洞或模糊性來獲取高獎勵,卻未真正學習或完成任務。隨著語言模型與 RLHF 的普及,獎勵竊取成為實作部署的主要障礙。
最新內容
依發布時間
Harness Engineering for Self-Improvement
探討了「自增強工程」(Harness Engineering) 如何推動 AI 的自改進。作者指出,透過設計包含工作流自動化、持久化記憶與子代理管理的系統,AI 不僅能提升效能,更能透過自我反思與演進來最佳化自身架構。
Scaling Laws, Carefully
深入探討了深度學習中的「規模定律」(Scaling Laws),指出訓練損失與模型大小、資料量及計算資源呈冪律關係。作者強調,雖然理論預測了這些關係,但在實際應用中,如何精確擬合這些定律並避免過度擬合(overfitting)仍是關鍵挑戰。
Why We Think
探討了測試時計算(Test-time compute)如何透過延遲思考來提升模型表現。作者指出,將模型視為資源進行最佳化,並結合心理學中的「快思考」與「慢思考」理論,解釋了為何延遲思考能挑戰本能並促進更理性的決策。
Reward Hacking in Reinforcement Learning
探討了強化學習(RL)中的「獎勵竊取」現象,即代理利用獎勵函式的漏洞或模糊性來獲取高獎勵,卻未真正學習或完成任務。隨著語言模型與 RLHF 的普及,獎勵竊取成為實作部署的主要障礙。
Extrinsic Hallucinations in LLMs
探討大語言模型的「外延謬誤」,即模型基於預訓練資料而非上下文生成錯誤內容的現象。作者指出,為避免謬誤,模型必須兼具事實準確性與承認不知情的能力。
Diffusion Models for Video Generation
介紹了從頭開始構建自定義的 Diffusion Video Models (VDM) 的方法。文章詳述了 DDIM 更新規則、VDM 的 3D U-Net 架構設計,以及 Imagen Video、Make-A-Video 等現有模型的關…
Thinking about High-Quality Human Data
探討了高品質人類資料在現代深度學習模型訓練中的核心地位。作者指出,雖然許多技術能輔助資料質量,但資料收集本身需要精細的執行與細節關注。文章透過「智慧群眾」的歷史案例,介紹了如何透過設計任務、篩選評審者、聚合資料來提升質量。
Adversarial Attacks on LLMs
探討了大語言模型(LLM)面臨的攻擊性威脅,包括白盒與黑盒下的攻擊方式。作者指出,雖然模型在訓練時已加入安全機制,但攻擊者仍可能透過修改字元、利用梯度或進行提示工程來誘發不想要的輸出。
LLM Powered Autonomous Agents
介紹了基於大語言模型(LLM)的自主代理系統架構。核心在於將 LLM 視為代理的「大腦」,並結合規劃、子目標分解、反思修正、記憶管理以及工具使用等關鍵模組。
Prompt Engineering
介紹了 Prompt Engineering(即 In-Context Prompting),是一種透過在提示中提供範例來引導大語言模型行為的方法,無需更新模型權重即可達成目標。
The Transformer Family Version 2.0
這篇文章是 Lilian Weng 對 2020 年《Transformer 家族》文章的全面重構與更新,涵蓋了更多近期的論文與架構改進。
Large Transformer Model Inference Optimization
探討如何最佳化大型 Transformer 模型的推理效能。透過知識蒸餾、量化技術(如混合精度與分組量化)、稀疏化架構(如 MoE)以及適應性注意力機制,大幅降低記憶體佔用與計算複雜度,使大規模模型在實際應用中更具可行性。
Some Math behind Neural Tangent Kernel
深入解析了神經網路中的「神經切線核 (NTK)」。透過梯度下降,文章解釋了當網路寬度無限大時,模型的預測如何穩定地趨近於全域性最小值,而不受初始引數影響。
Generalized Visual Language Models
介紹了多模態通用語言模型(VLMs)的四種主要架構:將圖片轉為嵌入特徵、作為字首訓練預訓練語言模型、使用交叉注意力機制融合視覺資訊,以及完全不進行訓練直接結合。
Learning with not Enough Data Part 3: Data Generation
探討了資料不足時如何生成合成資料。作者介紹了兩種主要方法:一是資料增強,透過對現有樣本進行扭曲或轉換來保留關鍵屬性;二是新資料生成,利用預訓練語言模型產生新資料點。
Learning with not Enough Data Part 2: Active Learning
探討在標籤資料有限且預算受限的情況下,如何透過主動學習策略來高效地選擇樣本進行標籤。文章介紹了多種基於不確定性、多樣性與核心集的概念,並展示了實際應用於影像分類與分割任務的方法。
Learning with not Enough Data Part 1: Semi-Supervised Learning
探討在標籤資料不足時,半監督式學習的四種主要方法:預訓練加精調、主動學習、自訓練與生成式資料自動生成。文章指出現有研究多聚焦於視覺任務,而語言任務則傾向於預訓練加精調。
How to Train Really Large Models on Many GPUs?
探討如何將大型神經網路模型在多台 GPU 上高效訓練。作者介紹了資料並行、計算並行、分層並行、分塊並行以及分塊並行等並行策略,並深入分析了混合精度訓練、ZeRO 最佳化器以及稀疏化專家混合模型(MoE)等技術如何解決記憶體瓶頸與訓練效率問…
Contrastive Representation Learning
介紹了對比表示學習(Contrastive Representation Learning)的核心概念與訓練目標。它解釋了如何透過將相似樣本拉近、將不相似樣本推開來學習嵌入空間,並涵蓋了從早期的 Triplet Loss 到最新的 MoC…
Reducing Toxicity in Language Models
探討如何降低大語言模型的毒性。作者指出,雖然模型強大且成功率高,但部署時需要強烈的安全控制。文章列舉了毒性定義的困難、內容分類方法(如 OLID 和 SOLID 資料集)、資料收集策略(如人工標註和 crowdsourcing),以及檢測…
Controllable Neural Text Generation
探討如何在不修改模型權重的情況下,對未條件化語言模型進行內容控制。作者介紹了多種方法,包括測試時採用引導解碼策略、透過最佳化的提示設計來最佳化結果,以及對基礎模型或可控制層進行微調以實現條件生成。
How to Build an Open-Domain Question Answering System?
介紹了如何建構開放域問答系統,涵蓋了從傳統 TF-IDF 到現代神經網路的 Retriever-Reader 框架。作者指出,當模型無法記憶訓練資料中的上下文時,必須結合外部知識庫進行檢索,再透過讀取器提取答案。
Neural Architecture Search
探討了神經架構搜尋(NAS)的核心概念,包括搜尋空間設計、搜尋演算法與評估策略。文章指出,雖然現有架構多由專家設計,但透過系統化與自動化的學習方法,才能更有效地探索並找到最佳架構。
Exploration Strategies in Deep Reinforcement Learning
探討深度強化學習中的探索策略,強調探索與利用的平衡。作者介紹了多種經典方法,包括epsilon-greedy、上界置信邊界、玻爾茲曼探索及厚薄 sampling。
The Transformer Family
這篇文章詳細介紹了 Transformer 家族中多種改進模型,包括長上下文注意力機制 Transformer-XL、可逆計算 Universal Transformer 以及針對強化學習的 GTrXL。
Curriculum for Reinforcement Learning
探討如何透過課程學習(Curriculum Learning)提升強化學習(Reinforcement Learning)的效率。作者指出,設計一個有效的課程需要解決兩個核心問題:如何量化任務的難度,以及如何提供難度遞增的任務序列。
Self-Supervised Representation Learning
介紹了自監督學習(Self-Supervised Learning)的概念與應用。透過將監督學習任務轉化為預測部分資訊,利用大量無標籤資料進行訓練,例如預測圖片旋轉、拼圖或時間順序等。
Domain Randomization for Sim2Real Transfer
介紹了域隨機化(Domain Randomization)作為解決模擬到現實轉移(Sim2Real)難題的方法。透過在模擬環境中隨機化物理引數與場景,模型可泛化至真實世界。