Quantization-Aware Healing: a compressed, 4-bit model that outperforms its full-precision original
介紹了 Quantization-Aware Healing (QAH),一種能修復結構壓縮與量化損傷的 4-bit 模型方法。
Quantization & Distillation ・ 26 筆內容
把模型變小、變快:量化、蒸餾、剪枝。
也叫做:量化、quantization、蒸餾、蒸馏、distillation、GGUF、剪枝、pruning、模型壓縮
由淺入深:入門 → 進階 → 高階
Stop Chunking Like It's 2022 — Yuval Belfer, AI21 Labs(在新分頁開啟原站)
AI Engineer18 分鐘○ 無原文
The distillation panic(在新分頁開啟原站)
Interconnects9 分鐘○ 無原文
179: 蒸馏风暴:一场无人公开谈论的技术竞赛(在新分頁開啟原站)
晚点聊 LateTalk50 分鐘○ 無原文
Training Agents 2: Live tutorial on model distillation for training custom agents.(在新分頁開啟原站)
Hugging Face1 小時 8 分○ 無原文
员工蒸馏:水没有了,鱼要变成“四维生物”(在新分頁開啟原站)
硅谷1013 分鐘○ 無原文
EP127 - 中國 AI 的蒸餾攻擊被抓到、Anthropic 與國防部決裂!糾紛之外的重要議題(在新分頁開啟原站)
科技浪 Tech.wav1 小時 13 分○ 無原文
152. 领读Kimi K3技术报告:从架构创新聊起,注意力美学、多教师蒸馏和开源MoE
Zhang Xiaojun Podcast2 小時 4 分● 有原文
Making Knowledge Distillation Cheap Enough to Run at Scale
Hugging Face Blog● 有原文
Owning the AI Pareto Frontier — Jeff Dean(在新分頁開啟原站)
Latent Space1 小時 24 分○ 無原文
Hugging Face Journal Club: Direct On-Policy Distillation(在新分頁開啟原站)
Hugging Face33 分鐘○ 無原文
依相關、人氣、新鮮度綜合排序;站長推薦的加成
介紹了 Quantization-Aware Healing (QAH),一種能修復結構壓縮與量化損傷的 4-bit 模型方法。
影片由 Yuval Belfer 介紹如何避免像 2022 年那樣過度切分資料,並分享實戰技巧。
※ 摘要僅根據標題與說明
探討了「蒸餾攻擊」的誤用,指出將此技術泛化為所有蒸餾行為會混淆概念,導致誤判。作者強調需謹慎評估對中國大模型的影響,避免將正常的研發技術誤認為企業或國家的不當行為。
※ 摘要僅根據標題與說明
介紹如何透過模型蒸餾技術訓練自訂的 AI 代理,內容聚焦於實作步驟與技術原理,讓讀者掌握建立高效代理的方法。
※ 摘要僅根據標題與說明
※ 摘要僅根據標題與說明
※ 摘要僅根據標題與說明
前 Meta 資料科學家 Jimmy 回顧公司裁員內幕,指出量化人才被砍光,質性研究員亦面臨取代危機。
※ 摘要僅根據標題與說明
探討 AsyncOPD 模型在 On-Policy Distillation 中的穩定性問題,分析其潛在風險。
※ 摘要僅根據標題與說明
介紹了如何透過最佳化知識蒸餾(Knowledge Distillation)流程,大幅降低其計算與記憶體成本。作者提出兩種系統性改動:將教師模型的 logits 預先儲存並僅在訓練時使用,以及採用分塊計算的 KL 散度損失,避免一次性構建…
探討 distilled 技術在中文大語言模型中的實際應用。作者指出,目前主流的 distilled 方法更多是將強模型輸出轉化為合成資料,而非直接複製能力。
※ 摘要僅根據標題與說明
※ 摘要僅根據標題與說明
本節目由 Nathan Lambert 與 Sebastian Raschka 主持,探討 Anthropic 的模型壓縮技術(Distillation)及其如何讓模型「作弊」,特別針對 SWE-Bench 等測試集失效的問題進行分析。
※ 摘要僅根據標題與說明
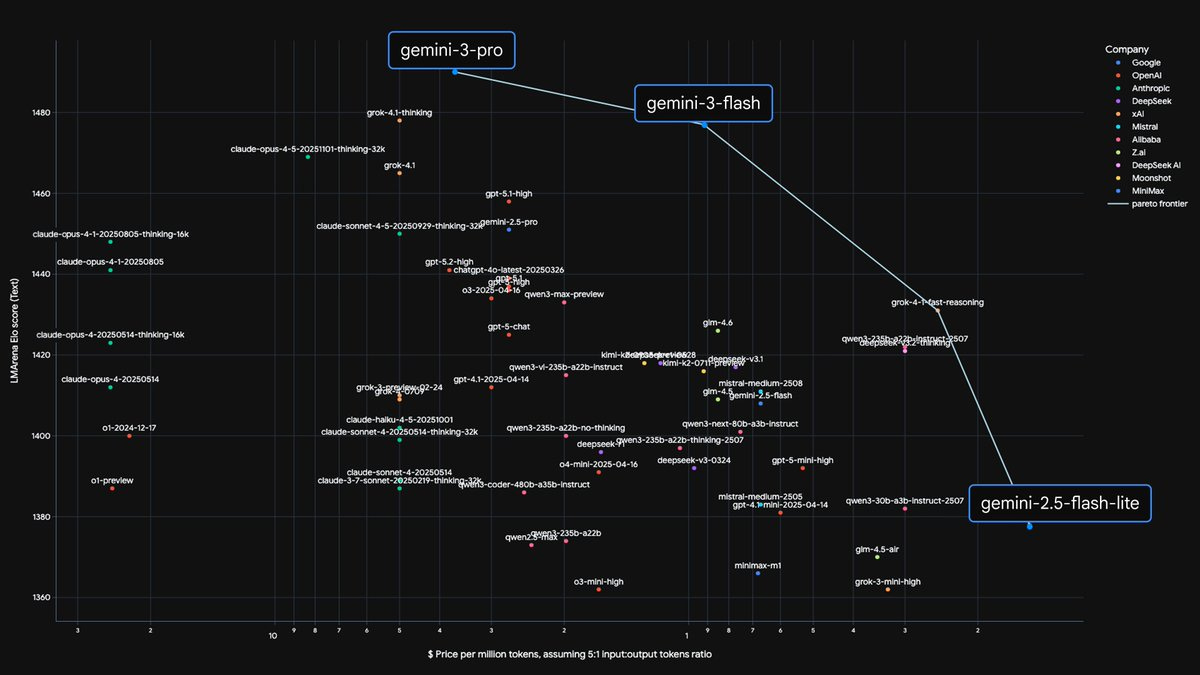
Jeff Dean 探討如何掌握 AI 帕累託前沿,解析 Flash 模型突破的關鍵在於蒸餾技術,並指出能耗正取代 FLOPs 成為新瓶頸。
※ 摘要僅根據標題與說明
影片揭露中國 AI 蒸餾攻擊被發現,並提及與國防部發生嚴重衝突,強調糾紛背後還有其他重要議題。
※ 摘要僅根據標題與說明
依發布時間
介紹 DeepSeek V4.1 Flash 與 Bonsai 2 兩大技術,大幅壓縮 KV Cache 與模型權重。DeepSeek V4.1 Flash 將 Token 的 KV Cache 壓縮至 1KB,DeepSeek 將 V1…
清藍創始人魯陽指出,SEO 與 GEO 是不同物種:SEO 依賴搜尋引擎規則,可手工最佳化;而大模型無固定規則,需透過演算法挖掘內容特徵。
影片由 Yuval Belfer 介紹如何避免像 2022 年那樣過度切分資料,並分享實戰技巧。
※ 摘要僅根據標題與說明
前 Meta 資料科學家 Jimmy 回顧公司裁員內幕,指出量化人才被砍光,質性研究員亦面臨取代危機。
※ 摘要僅根據標題與說明
本集播客由孫宇領讀 Kimi K3 技術報告,該報告提出沿序列、深度與寬度三個維度擴充套件的 MoE 架構。報告指出 K3 透過將注意力機制從 token 切分為值域桶並進行統計,實現了高效擴充套件,同時採用全量訓練以確保訓練穩定性與相容…
介紹了 Quantization-Aware Healing (QAH),一種能修復結構壓縮與量化損傷的 4-bit 模型方法。
※ 摘要僅根據標題與說明
這篇影片探討了 Hugging Face 團隊提出的「直接對策蒸餾」方法,透過將小模型在 RL 中的策略變化作為密集獎勵訊號,來訓練大模型。此方法能以極低計算成本實現弱到強的一般化,有效複製或超越直接 RL 在大模型上的表現。
※ 摘要僅根據標題與說明
介紹了如何透過最佳化知識蒸餾(Knowledge Distillation)流程,大幅降低其計算與記憶體成本。作者提出兩種系統性改動:將教師模型的 logits 預先儲存並僅在訓練時使用,以及採用分塊計算的 KL 散度損失,避免一次性構建…
孟繁青探討合成資料與 RSI 如何重塑模型競爭。他指出,雖然國模常依賴蒸餾加速,但真正的競爭力來自於 Pre-training 階段因資源限制倒逼出的創新架構。
※ 摘要僅根據標題與說明
前 Meta 量化研究員 Jimmy 分享公司內部裁員內幕,揭露量化人才被砍光、質性研究員亦遭取代的現實。他回顧從 Amazon 到 Meta 的職涯,並談及公司鼓勵員工使用 AI 卻引發內部反彈的真實情況。
※ 摘要僅根據標題與說明
本播客探討中國模型 Kimi K3 如何引發矽谷對「蒸餾」的激烈爭議。前 Hugging Face 負責人與 TinyFish 創始人從技術與商業角度分析,當中國模型能力逼近前沿時,矽谷正重新評估其對閉源模型的衝擊,並討論開放權重對 Ag…
※ 摘要僅根據標題與說明