1影片進階EN
How to Read Deep Learning Papers? (2026)
分享閱讀深度學習論文的方法,透過七個步驟從理解背景到與作者對話。看完能掌握如何高效閱讀並理解複雜的 AI 研究文獻。
2.5 萬次觀看
※ 摘要僅根據標題與說明
YouTube ・ 國際 ・ 英文 ・ A 級 ・ 4.4 萬 訂閱 ・ 8 筆內容 ・ 最近更新 2026/10/06
邀論文作者一起逐段講新論文(RLM、world model、合成預訓練資料),也教怎麼讀深度學習論文
依人氣
分享閱讀深度學習論文的方法,透過七個步驟從理解背景到與作者對話。看完能掌握如何高效閱讀並理解複雜的 AI 研究文獻。
※ 摘要僅根據標題與說明
與 MIT 博士生 Jayden Teoh 訪談 Next-Latent Prediction Transformers,探討如何透過預測模型自身隱藏狀態來學習緊湊的世界模型。
※ 摘要僅根據標題與說明
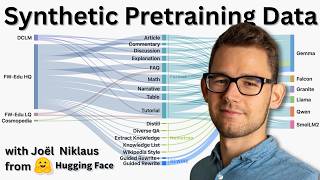
影片與 Hugging Face 的機器學習工程師 Joël Niklaus 探討生成合成預訓練資料的實作方法。透過分析 90 項受控實驗與海量資料,揭示構建高品質預訓練資料的關鍵原則與流程。
※ 摘要僅根據標題與說明
由 NVIDIA 資深產品研究工程師 Chris Alexiuk 主講,深入解析 Nemotron 3 Ultra 開放模型的建構過程與理念。
※ 摘要僅根據標題與說明
介紹 Seth Karten 開發的 Prime Agent,一種能自我改進的語言模型架構。透過群體溝通與可編輯的執行環境,讓模型能自主執行複雜任務並最佳化自身。
※ 摘要僅根據標題與說明
Alex Zhang 介紹 Recursive Language Models 如何透過 Python REPL 執行提示,讓模型能自定義處理並處理長任務與新領域。影片說明 RLM 比傳統變換器模型更具元件泛化能力,並探討其原理與未來方向。
※ 摘要僅根據標題與說明
論文探討預訓練大型語言模型周圍存在著許多專精於特定任務的專家模型,挑戰了傳統認為預訓練會找到單一最佳權重集的看法。透過生物學中的平衡效應概念,作者提出這些專家模型像山谷周圍的山脈般密集分佈,對後續的模型訓練與知識轉移有深遠影響。
※ 摘要僅根據標題與說明
探討大型語言模型在 MazeBench 複雜迷宮任務中的表現,分析當前系統在邏輯推理與空間理解上的不足。觀眾可了解模型在處理高難度挑戰時的具體失敗案例與能力缺口。
※ 摘要僅根據標題與說明
依發布時間
Alex Zhang 介紹 Recursive Language Models 如何透過 Python REPL 執行提示,讓模型能自定義處理並處理長任務與新領域。影片說明 RLM 比傳統變換器模型更具元件泛化能力,並探討其原理與未來方向。
※ 摘要僅根據標題與說明
由 NVIDIA 資深產品研究工程師 Chris Alexiuk 主講,深入解析 Nemotron 3 Ultra 開放模型的建構過程與理念。
※ 摘要僅根據標題與說明
與 MIT 博士生 Jayden Teoh 訪談 Next-Latent Prediction Transformers,探討如何透過預測模型自身隱藏狀態來學習緊湊的世界模型。
※ 摘要僅根據標題與說明
影片與 Hugging Face 的機器學習工程師 Joël Niklaus 探討生成合成預訓練資料的實作方法。透過分析 90 項受控實驗與海量資料,揭示構建高品質預訓練資料的關鍵原則與流程。
※ 摘要僅根據標題與說明
介紹 Seth Karten 開發的 Prime Agent,一種能自我改進的語言模型架構。透過群體溝通與可編輯的執行環境,讓模型能自主執行複雜任務並最佳化自身。
※ 摘要僅根據標題與說明
分享閱讀深度學習論文的方法,透過七個步驟從理解背景到與作者對話。看完能掌握如何高效閱讀並理解複雜的 AI 研究文獻。
※ 摘要僅根據標題與說明
探討大型語言模型在 MazeBench 複雜迷宮任務中的表現,分析當前系統在邏輯推理與空間理解上的不足。觀眾可了解模型在處理高難度挑戰時的具體失敗案例與能力缺口。
※ 摘要僅根據標題與說明
論文探討預訓練大型語言模型周圍存在著許多專精於特定任務的專家模型,挑戰了傳統認為預訓練會找到單一最佳權重集的看法。透過生物學中的平衡效應概念,作者提出這些專家模型像山谷周圍的山脈般密集分佈,對後續的模型訓練與知識轉移有深遠影響。
※ 摘要僅根據標題與說明