1影片進階EN
Stop Sending Your Private Data to OpenAI's Servers
說明 ChatGPT 桌面版預設會將敏感資料上傳至雲端並用於訓練模型,並教導使用者如何透過 Ollama 在 Mac 上設定本地模型。看完後能學會如何讓 AI 在本地執行以保護隱私,並了解雲端與本地模型的差異。
※ 摘要僅根據標題與說明
YouTube ・ 國際 ・ 英文 ・ B 級 ・ 9.6 萬 訂閱 ・ 9 筆內容 ・ 最近更新 2026/09/18
本機模型(Ollama)與 agent 工具的實作與評測,夾雜閒聊節目與短片
依人氣
說明 ChatGPT 桌面版預設會將敏感資料上傳至雲端並用於訓練模型,並教導使用者如何透過 Ollama 在 Mac 上設定本地模型。看完後能學會如何讓 AI 在本地執行以保護隱私,並了解雲端與本地模型的差異。
※ 摘要僅根據標題與說明
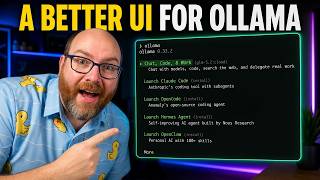
介紹 Ollama 新的互動式終端介面,取代傳統輸入指令的方式,讓使用者能更輕鬆地發現模型、代理與工具。觀眾將學習如何使用新選單、隱藏技巧及關鍵指令來最佳化本地 AI 工作流。
※ 摘要僅根據標題與說明
教導如何在遠端伺服器上設定 Obsidian Headless,建立供 AI 代理即時讀寫的加密知識庫。觀眾將學習安裝、配置系統服務以確保記憶持久化,並讓代理存取 Markdown 檔案儲存資料。
※ 摘要僅根據標題與說明
揭露雲端 AI 整合如 Claude Desktop 透過 MCP 協議帶來的隱私風險,包括資料留存與提示注入漏洞。觀眾可學習如何將雲端模型替換為本地 Ollama 模型,在保留功能同時保障資料安全。
※ 摘要僅根據標題與說明
介紹 Apple 摺疊機反應、Samsung 與 Apple 的互動,以及 Claude Desktop 中本地 LLM 的運作與社群修改。
※ 摘要僅根據標題與說明
Matt 與 Ryan 討論快速本地大模型、學校禁止 AI 的現象、創意與程式工作流中的生成式 AI 應用,以及 Apple 新硬體與腦感測技術的猜測。
※ 摘要僅根據標題與說明
介紹 Ollama 雲端定價模式轉向按 token 收費、新推出的快速模型(如 Fable 5.1、GLM 5.3 Flash)以及 Apple 摺疊手機的市場猜測。
※ 摘要僅根據標題與說明
記錄開發者克服倦怠、調整影片製作節奏,並分享 GLM 5.2 與 Sonnet/Opus 等模型的實際工作流。內容涵蓋程式環境工具選擇、生成式軟體訂閱陷阱,以及用 AI 編碼可能帶來的技能退化議題。
※ 摘要僅根據標題與說明
記錄 OpenAI 與 Claude 同時停機期間,如何利用本地模型(如 Ollama、Qwen 3.5)提升速度並節省費用,並探討 Nvidia 債務迴圈與手機執行本地模型的可能性。
※ 摘要僅根據標題與說明
依發布時間
說明 ChatGPT 桌面版預設會將敏感資料上傳至雲端並用於訓練模型,並教導使用者如何透過 Ollama 在 Mac 上設定本地模型。看完後能學會如何讓 AI 在本地執行以保護隱私,並了解雲端與本地模型的差異。
※ 摘要僅根據標題與說明
介紹 Apple 摺疊機反應、Samsung 與 Apple 的互動,以及 Claude Desktop 中本地 LLM 的運作與社群修改。
※ 摘要僅根據標題與說明
揭露雲端 AI 整合如 Claude Desktop 透過 MCP 協議帶來的隱私風險,包括資料留存與提示注入漏洞。觀眾可學習如何將雲端模型替換為本地 Ollama 模型,在保留功能同時保障資料安全。
※ 摘要僅根據標題與說明
Matt 與 Ryan 討論快速本地大模型、學校禁止 AI 的現象、創意與程式工作流中的生成式 AI 應用,以及 Apple 新硬體與腦感測技術的猜測。
※ 摘要僅根據標題與說明
介紹 Ollama 新的互動式終端介面,取代傳統輸入指令的方式,讓使用者能更輕鬆地發現模型、代理與工具。觀眾將學習如何使用新選單、隱藏技巧及關鍵指令來最佳化本地 AI 工作流。
※ 摘要僅根據標題與說明
介紹 Ollama 雲端定價模式轉向按 token 收費、新推出的快速模型(如 Fable 5.1、GLM 5.3 Flash)以及 Apple 摺疊手機的市場猜測。
※ 摘要僅根據標題與說明
教導如何在遠端伺服器上設定 Obsidian Headless,建立供 AI 代理即時讀寫的加密知識庫。觀眾將學習安裝、配置系統服務以確保記憶持久化,並讓代理存取 Markdown 檔案儲存資料。
※ 摘要僅根據標題與說明
記錄開發者克服倦怠、調整影片製作節奏,並分享 GLM 5.2 與 Sonnet/Opus 等模型的實際工作流。內容涵蓋程式環境工具選擇、生成式軟體訂閱陷阱,以及用 AI 編碼可能帶來的技能退化議題。
※ 摘要僅根據標題與說明
記錄 OpenAI 與 Claude 同時停機期間,如何利用本地模型(如 Ollama、Qwen 3.5)提升速度並節省費用,並探討 Nvidia 債務迴圈與手機執行本地模型的可能性。
※ 摘要僅根據標題與說明