EP416 – 史丹佛 CS329A 課程大公開:多步驟任務如何規劃?LATS、SPRINT、SWiRL
整理史丹佛 CS329A 課程關於多步驟任務規劃的三篇論文:LATS、SPRINT 與 SWiRL。LATS 透過樹狀搜尋與回溯讓 Agent 在執行時多條路徑比較,SPRINT 利用微調讓模型同時規劃並執行互不相干的步驟,SWiRL 則…
17 筆內容提到
最近 7 天 1 筆(再前 7 天 1 筆)
也寫作:DeepSeek-R1
這一頁列的是「提到 DeepSeek R1」的內容(名稱由語言模型從內容裡整理),不一定整筆都在講它。只想追它的新內容:訂閱 RSS;想找標題裡就有它的:搜尋「DeepSeek R1」。
依發布時間
整理史丹佛 CS329A 課程關於多步驟任務規劃的三篇論文:LATS、SPRINT 與 SWiRL。LATS 透過樹狀搜尋與回溯讓 Agent 在執行時多條路徑比較,SPRINT 利用微調讓模型同時規劃並執行互不相干的步驟,SWiRL 則…
AstA 團隊公開了專為科學報告生成設計的開源模型 AstaBrief 8B,透過監督微調與偏好最佳化訓練,在保持引用準確性的同時,將報告生成速度提升約 3.5 倍。
梳理過去一個季度 AI 行業動態,涵蓋模型密集發布、開源與閉源競爭、企業自建智慧基礎設施、Agent 迴圈自生及介面重構等趨勢。內容探討如何從單純呼叫 API 轉向構建適合自身業務的智慧系統,並分析當前產品複雜度轉嫁使用者的問題。
介紹 Interconnects 推出的新工具,包含追蹤 Hugging Face 趨勢模型的 Artifacts Hub 與顯示全球下載資料的 Adoption Dashboard。
由斯坦福大學 Azalia Mirhoseini 教授主講,深入解析三篇關於語言模型代理的規劃與多步驟推理論文。內容涵蓋結合蒙特卡洛樹搜尋的 LATS 方法、利用並行執行提升效率的 SPRINT 模型,以及透過合成資料訓練實現跨任務泛化的…
Moonshot AI 推出 2800 億參數開源模型 Kimi K3,縮短中美模型效能差距至 3-5 個月。文章分析開源模型如何改變生態系,並探討中國在資金效率與架構創新上的優勢。
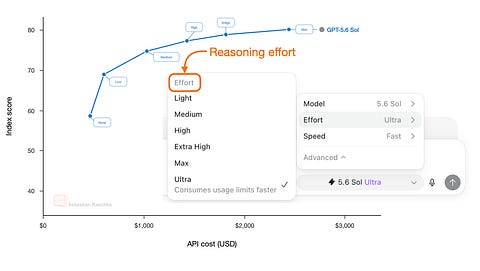
深入解析大型語言模型(LLM)如何透過訓練與推理縮放技術,實現低、中、高不同「推理努力度」的切換機制。作者以 GPT-5.6 等最新模型為例,說明從強化學習(RLVR)到推理時長控制的實作細節,幫助讀者理解如何平衡準確度、成本與延遲。
訪談斯坦福大學 Yejin Choi 教授,探討如何透過高品質、多樣化的資料與合成資料生成,讓小型語言模型具備更強的推理能力。內容涵蓋「稜鏡合成」等技術、避免模型輸出單一化,以及推動 AI 民主化與多元對齊的社會意義。
Sebastian Raschka 回顧 2025 年大型語言模型發展,重點分析 DeepSeek R1 帶來的推理模型突破與 RLVR 演算法。
深入解析 DeepSeek V3.2 的架構演進,涵蓋稀疏注意力機制、自驗證訓練方法與 GRPO 最佳化細節,並對比其與 V3、R1 及 Qwen3 等模型的差異。讀者可掌握最新開源大模型的技術亮點與訓練策略。
探討大型語言模型推理過程過長是否必要,指出推理長度與正確率未必正相關,反而消耗額外算力。透過控制提示詞、調整參數、知識蒸餾及強化學習獎勵機制,可訓練出推理短且準確的模型,達到資源效率與效能的平衡。
李宏毅教授介紹大型語言模型如何透過深度思考(Reasoning)提升推理能力,涵蓋思維鏈、模仿學習與強化學習等方法。課程以 DeepSeek-R1 為例,說明模型如何模擬人類思考過程並進行自我驗證,同時探討測試時運算(Test Time…
深入解析 DeepSeek-V2 與 R1 如何重新設計 Transformer 架構,透過 KV Cache 壓縮與注意力機制最佳化提升效率。觀眾能理解這些技術如何減少計算資源並改善模型表現。
※ 摘要僅根據標題與說明
透過演算法題、工程題與邏輯遊戲,實測 Grok3、Claude 3.7、DeepSeek R1 與 o3 mini high 的推理與程式設計能力。
示範如何使用 DeepSeek R1 與 AnythingLLM 搭建完全本地化的知識庫,解決大模型杜撰問題。觀眾可學習安裝 Ollama、下載模型並配置多工作區與語言設定。
※ 摘要僅根據標題與說明
示範如何在本機安裝 DeepSeek-R1 模型,包含 Ollama、Docker 與 Open WebUI 的設定步驟。觀眾可學習將大型語言模型私有化部署,並透過圖形介面進行對話與模型切換。
透過實際程式設計與邏輯推理測試,對比 DeepSeek R1 與 OpenAI o1 在演算法題、遊戲開發及文字解密上的表現。重點分析 R1 詳盡的思考過程與極具競爭力的價格優勢,探討其對 AI 產業的潛在影響。
依人氣
深入解析 DeepSeek-V2 與 R1 如何重新設計 Transformer 架構,透過 KV Cache 壓縮與注意力機制最佳化提升效率。觀眾能理解這些技術如何減少計算資源並改善模型表現。
※ 摘要僅根據標題與說明
深入解析大型語言模型(LLM)如何透過訓練與推理縮放技術,實現低、中、高不同「推理努力度」的切換機制。作者以 GPT-5.6 等最新模型為例,說明從強化學習(RLVR)到推理時長控制的實作細節,幫助讀者理解如何平衡準確度、成本與延遲。
Moonshot AI 推出 2800 億參數開源模型 Kimi K3,縮短中美模型效能差距至 3-5 個月。文章分析開源模型如何改變生態系,並探討中國在資金效率與架構創新上的優勢。
介紹 Interconnects 推出的新工具,包含追蹤 Hugging Face 趨勢模型的 Artifacts Hub 與顯示全球下載資料的 Adoption Dashboard。
Sebastian Raschka 回顧 2025 年大型語言模型發展,重點分析 DeepSeek R1 帶來的推理模型突破與 RLVR 演算法。
深入解析 DeepSeek V3.2 的架構演進,涵蓋稀疏注意力機制、自驗證訓練方法與 GRPO 最佳化細節,並對比其與 V3、R1 及 Qwen3 等模型的差異。讀者可掌握最新開源大模型的技術亮點與訓練策略。
由斯坦福大學 Azalia Mirhoseini 教授主講,深入解析三篇關於語言模型代理的規劃與多步驟推理論文。內容涵蓋結合蒙特卡洛樹搜尋的 LATS 方法、利用並行執行提升效率的 SPRINT 模型,以及透過合成資料訓練實現跨任務泛化的…
李宏毅教授介紹大型語言模型如何透過深度思考(Reasoning)提升推理能力,涵蓋思維鏈、模仿學習與強化學習等方法。課程以 DeepSeek-R1 為例,說明模型如何模擬人類思考過程並進行自我驗證,同時探討測試時運算(Test Time…
訪談斯坦福大學 Yejin Choi 教授,探討如何透過高品質、多樣化的資料與合成資料生成,讓小型語言模型具備更強的推理能力。內容涵蓋「稜鏡合成」等技術、避免模型輸出單一化,以及推動 AI 民主化與多元對齊的社會意義。
AstA 團隊公開了專為科學報告生成設計的開源模型 AstaBrief 8B,透過監督微調與偏好最佳化訓練,在保持引用準確性的同時,將報告生成速度提升約 3.5 倍。