1文章進階EN
12 GW announced. 5 GW under construction. What happens next?
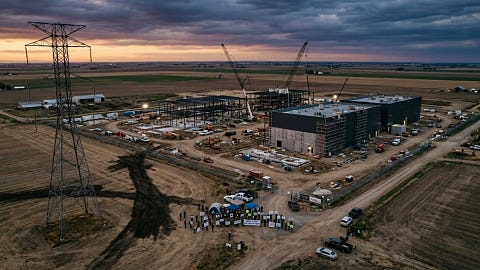
探討 AI 資料中心建設面臨的當地政治阻力與信任危機,指出已宣佈容量與實際施工容量之間存在巨大落差。作者分析社群反對如何從零星抗議轉化為系統性障礙,並警告若無法建立信任與實際供電能力,AI 基礎設施擴張可能面臨延遲或縮減。
部落格 ・ 國際 ・ 英文 ・ A 級 ・ 20 筆內容 ・ 最近更新 2026/10/06
從資料與基礎設施的角度看企業怎麼把 AI 做進產品:agent 的資料層、評測、開源工具趨勢;每週一篇
依人氣
探討 AI 資料中心建設面臨的當地政治阻力與信任危機,指出已宣佈容量與實際施工容量之間存在巨大落差。作者分析社群反對如何從零星抗議轉化為系統性障礙,並警告若無法建立信任與實際供電能力,AI 基礎設施擴張可能面臨延遲或縮減。
探討大模型實驗室如何從競爭通用模型轉向與企業客戶競爭,因為企業可將私有資料轉化為專屬智慧。內容介紹了從提示工程到強化學習微調的工程化流程,以及企業利用自有資料進行預訓練以建立競爭壁壘的趨勢。
指出傳統 AI 評估與紅隊測試無法涵蓋實際生產中的法律與合規風險,並引用 OpenAI、Workday 及德國法院的訴訟案例說明問題。作者建議採用高維度評估方法,結合法律專業知識,將 AI 風險測試視為與系統可靠性同等重要的持續工作。
探討 AI 模型在部署後學習能力停止的問題,介紹持續學習如何讓系統在實際使用中累積經驗並持續改進。讀者可了解企業如何將失敗轉化為可重用的訓練資料,以及相關技術挑戰與應用場景。
預測開放權重模型將吸收大部分 AI 開銷,因閉源模型定價疲軟且存在壟斷風險。作者建議企業建立包含閉源與開放模型的混合架構,以降低成本並避免供應商鎖定,同時提醒注意中國開放模型在特定領域的進步與美國模型的優勢差距。
探討企業如何透過混合使用專有與開源模型來降低大規模運作的成本與風險,指出單純依賴 API 定價對企業而言如同「規模稅」。內容涵蓋開源模型在隱私、控制力與自訂上的優勢,以及切換所需的工程挑戰與治理問題。
探討 Google 以 1000 萬美元收購 Spirit 航空內部資料的案例,指出企業價值正從最終成果轉向工作過程的記錄。
探討 AI 團隊常忽視的資料合規問題,指出內部營運資料比公開網路資料更具戰略價值。文章說明如何建立資料來源追蹤、處理版權風險及建構輕量級資料清單,以應對模型訓練與微調帶來的法律與技術挑戰。
透過訪談前 Google AI 主管 Andrew Moore,介紹 Lovelace 的 Elemental 平台如何自動構建與維護知識圖譜,解決企業 AI 代理在處理雜亂資料時的痛點。
提出九項實務架構原則,指導如何將 AI 代理應用於真實工作場景。內容強調將硬約束寫入軟體而非提示詞、限制代理自主權、基於領域現有流程設計系統,並透過檢核點與恢復機制提升可靠性。讀者可學習如何構建穩定、可治理且具備容錯能力的 AI 應用架構。
依發布時間
探討 AI 代理如何改變網路攻擊的經濟模型,指出 AI 能比人類快數倍地試錯並突破防禦。透過 Hugging Face 等案例,強調企業需重新評估安全假設,從規劃自動封鎖、強化代理權限管理到準備用 AI 防禦 AI。
探討 AI 與機器人如何從單純尋找原始資料,轉向建立將人類經驗轉化為可用資料的處理管道。作者指出數位代理與機器人面臨的挑戰不同,但核心問題都在於如何將原始素材轉化為安全可用的資料,並強調資料來源的驗證與使用權限的重要性。
指出當 AI 代理開始直接執行業務動作時,過時資料、定義模糊與權限遺失會造成嚴重後果,而非僅是分析錯誤。作者強調資料新鮮度、語義層建模與權限一致性至關重要,並說明資料架構需從觀察工具轉變為生產級應用基礎設施。
探討 Google 以 1000 萬美元收購 Spirit 航空內部資料的案例,指出企業價值正從最終成果轉向工作過程的記錄。
探討 AI 系統如何透過最佳化周圍的「工具集(harness)」而非僅升級模型來提升效能,並警告自動改進迴路可能導致指標操弄。作者主張將改進視為軟體發布,透過獨立測試與回滾機制確保安全,強調累積的生產日誌是未來資產。
探討在通用 AI 模型日益普及且價格低廉的背景下,企業如何建立難以複製的競爭優勢。作者認為,單純擁有模型或功能已不足夠,真正的護城河在於企業獨特的營運情境、工作流程與累積的判斷力。
提出九項實務架構原則,指導如何將 AI 代理應用於真實工作場景。內容強調將硬約束寫入軟體而非提示詞、限制代理自主權、基於領域現有流程設計系統,並透過檢核點與恢復機制提升可靠性。讀者可學習如何構建穩定、可治理且具備容錯能力的 AI 應用架構。
指出目前最大的 AI 風險不在模型本身,而在模型周圍的權限設定、訓練資料來源與使用者對高置信度回答的過度信任。作者強調需透過架構設計限制系統觸及範圍,並建立嚴謹的資料審計流程,同時設計介面讓使用者能識別並質疑 AI 的建議。
探討 AI 模型在部署後學習能力停止的問題,介紹持續學習如何讓系統在實際使用中累積經驗並持續改進。讀者可了解企業如何將失敗轉化為可重用的訓練資料,以及相關技術挑戰與應用場景。
指出傳統 AI 評估與紅隊測試無法涵蓋實際生產中的法律與合規風險,並引用 OpenAI、Workday 及德國法院的訴訟案例說明問題。作者建議採用高維度評估方法,結合法律專業知識,將 AI 風險測試視為與系統可靠性同等重要的持續工作。
探討大模型實驗室如何從競爭通用模型轉向與企業客戶競爭,因為企業可將私有資料轉化為專屬智慧。內容介紹了從提示工程到強化學習微調的工程化流程,以及企業利用自有資料進行預訓練以建立競爭壁壘的趨勢。
預測開放權重模型將吸收大部分 AI 開銷,因閉源模型定價疲軟且存在壟斷風險。作者建議企業建立包含閉源與開放模型的混合架構,以降低成本並避免供應商鎖定,同時提醒注意中國開放模型在特定領域的進步與美國模型的優勢差距。
指出超過 25 家新創公司正利用強化學習(RL)解決大模型在執行多步驟任務時不可靠的問題。這些公司專注於建立模擬環境、訓練場域以及評分機制,讓 AI 能在安全環境中練習並獲得回饋。
探討 AI 代理在執行任務時,應使用命令列介面(CLI)還是模型上下文協定(MCP)來與外部工具互動。作者分析兩者的優缺點,指出 CLI 熟悉且高效但缺乏安全防護,MCP 適合企業環境但可能有效能負擔。
透過訪談前 Google AI 主管 Andrew Moore,介紹 Lovelace 的 Elemental 平台如何自動構建與維護知識圖譜,解決企業 AI 代理在處理雜亂資料時的痛點。
探討 AI 團隊常忽視的資料合規問題,指出內部營運資料比公開網路資料更具戰略價值。文章說明如何建立資料來源追蹤、處理版權風險及建構輕量級資料清單,以應對模型訓練與微調帶來的法律與技術挑戰。
探討企業如何透過混合使用專有與開源模型來降低大規模運作的成本與風險,指出單純依賴 API 定價對企業而言如同「規模稅」。內容涵蓋開源模型在隱私、控制力與自訂上的優勢,以及切換所需的工程挑戰與治理問題。
探討 AI 資料中心建設面臨的當地政治阻力與信任危機,指出已宣佈容量與實際施工容量之間存在巨大落差。作者分析社群反對如何從零星抗議轉化為系統性障礙,並警告若無法建立信任與實際供電能力,AI 基礎設施擴張可能面臨延遲或縮減。
指出企業 AI 已超越單純的聊天機器人,轉向處理結構化資料、可觀測性與即時互動的專業模型。文章介紹了 Kumo、Datadog 與 Thinking Machines 等案例,說明未來企業 AI 將由預測引擎、系統模型與互動層組成的生態系…
透過 Upwork、DoorDash、Meta、EY 與 Fundrise 的實際案例,分析 AI 代理在真實業務流程中的運作模式與成功關鍵。讀者能了解不同企業如何將 AI 代理嵌入工作流,以及資料與治理在決定系統長期價值中的重要性。