What Is an Inference Engine, Anyway? — Charles Frye, Modal
Charles Frye 解析推理引擎如何處理從 API 請求到模型輸出的完整流程,涵蓋分詞、排程與 GPU 執行等關鍵環節。影片說明不同工作負載(如聊天機器人、背景代理)對延遲與吞吐量的影響,並探討 KV 快取與推測解碼等最佳化技術。
4,817次觀看
※ 摘要僅根據標題與說明
58 筆內容提到
最近 7 天 2 筆↑1(比前一期多 1 筆)(再前 7 天 1 筆)
這一頁列的是「提到 PyTorch」的內容(名稱由語言模型從內容裡整理),不一定整筆都在講它。只想追它的新內容:訂閱 RSS;想找標題裡就有它的:搜尋「PyTorch」。
依發布時間,最新的 30 筆
Charles Frye 解析推理引擎如何處理從 API 請求到模型輸出的完整流程,涵蓋分詞、排程與 GPU 執行等關鍵環節。影片說明不同工作負載(如聊天機器人、背景代理)對延遲與吞吐量的影響,並探討 KV 快取與推測解碼等最佳化技術。
※ 摘要僅根據標題與說明
分享如何透過 OCuLink 技術,將 NVIDIA RTX 5070 Ti 外接到 Framework Desktop,解決 AMD 平台跑 PyTorch 專案的 CUDA 支援問題。
介紹推理模型推論時的評分函式與自我改進技術,包含使用對數機率分數解決平手情況及實作自我修正迴圈。觀眾可學習如何計算 token 機率、評估模型答案並最佳化推理過程。
※ 摘要僅根據標題與說明
Hugging Face 將 llama.cpp 的 GGUF 量化格式整合進 transformers,透過 ggml 核心庫讓 Apple Silicon 裝置能以 Python 高效執行本地 AI 模型。
Daniel Svonava 分享如何讓小型開源模型在生產環境中發揮 frontier 級效能,透過任務分割與專用模型組合降低成本。
探討代理型 AI 如何改變推理工作負載,指出傳統 GPU 在生成階段面臨記憶體瓶頸。SambaNova 的 RDU 架構將整個模型空間化佈局,實現線性擴展與高並行,解決速度與吞吐量取捨問題,並可部署於既有資料中心。
透過重現 Geoffrey Hinton 的經典論文,一步步用 PyTorch 實作從 Boltzmann Machine 到 Deep Belief Networks 的演算法。
※ 摘要僅根據標題與說明
介紹 AI 工程師的職涯路徑與所需技能,區分機器學習研究員與 AI 工程師的差異。內容涵蓋從 Python、Git、Linux 等基礎,到 RAG、向量搜尋與 AI Agent,最後是 Kubernetes 部署與可觀測性,並提供實作專案…
AMD 企業 VP Anush Elangovan 分享 ROCm 10 如何透過 AI Agent 自動安裝、除錯與最佳化 GPU 工作負載。
介紹如何從零開始載入預訓練語言模型,解釋大型語言模型的文字生成機制,並說明使用 KV 快取提升效率的方法。觀眾可以學習基礎的模型載入與生成原理,為後續深入學習打下基礎。
※ 摘要僅根據標題與說明
介紹從零開始建立推理模型的動機與程式環境設定,涵蓋從傳統大型語言模型到推理模型的差異,並指導使用 uv 安裝 PyTorch 依賴。觀眾可學習如何配置開發環境並理解自製模型的基礎概念。
※ 摘要僅根據標題與說明
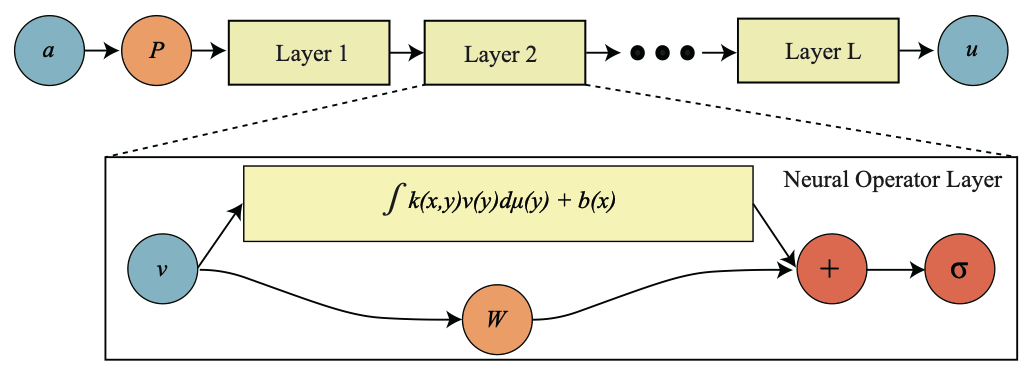
Anima Anandkumar 分享開發 FourCastNet 的經驗,用神經運算子將 AI 應用於天氣預測,在消費級 GPU 上實現比傳統模擬快數萬倍且準確的短期天氣預報。
從第一原理出發,使用 PyTorch 建立分散式訓練框架,涵蓋數學原理與並行技術實作。觀眾能學習如何將管道、資料、張量與專家並行整合成單一工作系統。
※ 摘要僅根據標題與說明
介紹如何使用 Strands Agents、LeRobot 與 Hugging Face Storage Buckets 建立一個完整的「記錄、訓練、部署」自動化迴圈。
介紹如何透過離線頂-K 機率分佈與融合分塊KL損失,大幅降低知識蒸餾所需的視訊記憶體與成本。透過將教師模型輸出快取並分塊計算損失,可避免建立龐大矩陣,使單張GPU即可進行長上下文蒸餾,並公開相關實作程式碼。
Hugo Bowne-Anderson 與 Sebastian Raschka 探討開放權重模型的重要性,指出其能避免對單一廠商的依賴並促進競爭。
Lin Qiao 與 Lukas Biewald 探討 Fireworks 每日處理超過 40 兆 token 的規模,並主張未來應發展基於企業私有資料的專業模型,而非通用大模型。
深入解析神經網路訓練的核心演算法後向傳播(Backpropagation),透過可微分電路的理論證明前向與後向計算時間同階。觀眾將學習如何利用鏈式法則高效計算損失函式對參數的梯度,並掌握處理矩陣乘法與激活函數的具體實作技巧。
訪談生數科技張金濤,深入探討 Vidu S1 實時互動影片模型的技術實現與推理加速策略。金濤分享了從 SageAttention 到 TurboDiffusion 的技術演進路徑,並解析了如何透過系統級最佳化讓生成速度超越播放速度,實現無…
介紹 PyTorch 深度學習框架的安裝與快速開始,適合具備 Python 基礎的開發者。看完即可掌握環境設定與基本測試方法,進入深度學習實作。
※ 摘要僅根據標題與說明
介紹 Fable 寫出高效 GPU 核碼的突破,分析 AI 自動化線上任務能力的提升,並探討 OSWORLD 2.0 benchmarks 顯示 AI 在複雜電腦操作上的進展。最後以虛構故事展望未來類比運算的應用。
訪談 Jure Leskovec 探討 AI for Science 與關係式深度學習。介紹 AI Virtual Cell 如何利用單細胞 RNA-seq 資料建立從蛋白質到患者的多尺度模型,並說明 Kumo 的 Relational…
Sebastian Raschka 分享從零用 Python 和 PyTorch 實作大型語言模型架構的經驗,說明實作細節如何幫助理解現代 LLM 運作原理。觀眾能學習如何閱讀模型卡片、比對參考實作,並掌握分析新架構的具體工作流。
※ 摘要僅根據標題與說明
深入探討推論工程(Inference Engineering),解釋為何它是 AI 最關鍵且複雜的工作負載。內容涵蓋從研究到生產的快速週期、關鍵技術如量化與 KV Cache 重用的應用,以及業界從 API 呼叫到自建平台的演進路徑。
前谷歌 TPU 工程師 Henry 深入解析 TPU 與 GPU 在架構、效能與生態上的差異,探討 TPU 如何透過客製化與供應鏈優勢挑戰輝達。
探討企業與國家如何透過自管基礎設施與合規策略實現 AI 主權,涵蓋 Kubernetes、PyTorch 等工具在 LLM 服務中的應用。內容涵蓋從 GPU 存取難題到代理身份認證等實務挑戰,幫助讀者理解 AI 主權的技術與營運路徑。
探討 Modulate 公司如何透過動態叢集架構解決語音 AI 的低延遲與高準確度挑戰。講者 Carter Huffman 解釋了為何單純的轉寫再轉語音流程無法捕捉語氣與情緒,並介紹了利用小型專模型組成的叢集系統,以平衡成本、延遲與多變環…
Spotify 首席架構師 Niklas Gustavsson 分享如何透過標準化與 Backstage 平台,在分散式架構中加速 AI 工具(如 Copilot、Cursor)的採用。
訪談 SaaS 產品與工程主管 Preeti Shukla,探討如何在多租戶軟體中安全地加入 AI 代理能力。內容涵蓋如何平衡延遲、成本與隱私,選擇合適的模型與架構,以及透過驗證與可觀測性系統來防止「自信錯誤」。
探討 Gimlet Labs 如何透過異質運算架構,將 AI 工作負載分散於不同硬體以提升效能與成本效益。講者介紹了將模型拆解、使用 LLM 自動最佳化運算核心等技術,並討論了從邊緣裝置到資料中心的應用挑戰。
依人氣
透過重現 Geoffrey Hinton 的經典論文,一步步用 PyTorch 實作從 Boltzmann Machine 到 Deep Belief Networks 的演算法。
※ 摘要僅根據標題與說明
介紹 AI 工程師的職涯路徑與所需技能,區分機器學習研究員與 AI 工程師的差異。內容涵蓋從 Python、Git、Linux 等基礎,到 RAG、向量搜尋與 AI Agent,最後是 Kubernetes 部署與可觀測性,並提供實作專案…
Andrej Karpathy 從零開始用程式碼手動編寫 GPT 模型,並結合 GitHub Copilot 輔助開發。觀眾能透過此影片理解自回歸語言模型的實作細節與 PyTorch 架構。
※ 摘要僅根據標題與說明
Charles Frye 解析推理引擎如何處理從 API 請求到模型輸出的完整流程,涵蓋分詞、排程與 GPU 執行等關鍵環節。影片說明不同工作負載(如聊天機器人、背景代理)對延遲與吞吐量的影響,並探討 KV 快取與推測解碼等最佳化技術。
※ 摘要僅根據標題與說明
Andrej Karpathy 示範如何從大雙字元語言模型逐步建構至現代 Transformer 模型,並深入解析 PyTorch Tensor 的細節與神經網路訓練架構。
※ 摘要僅根據標題與說明
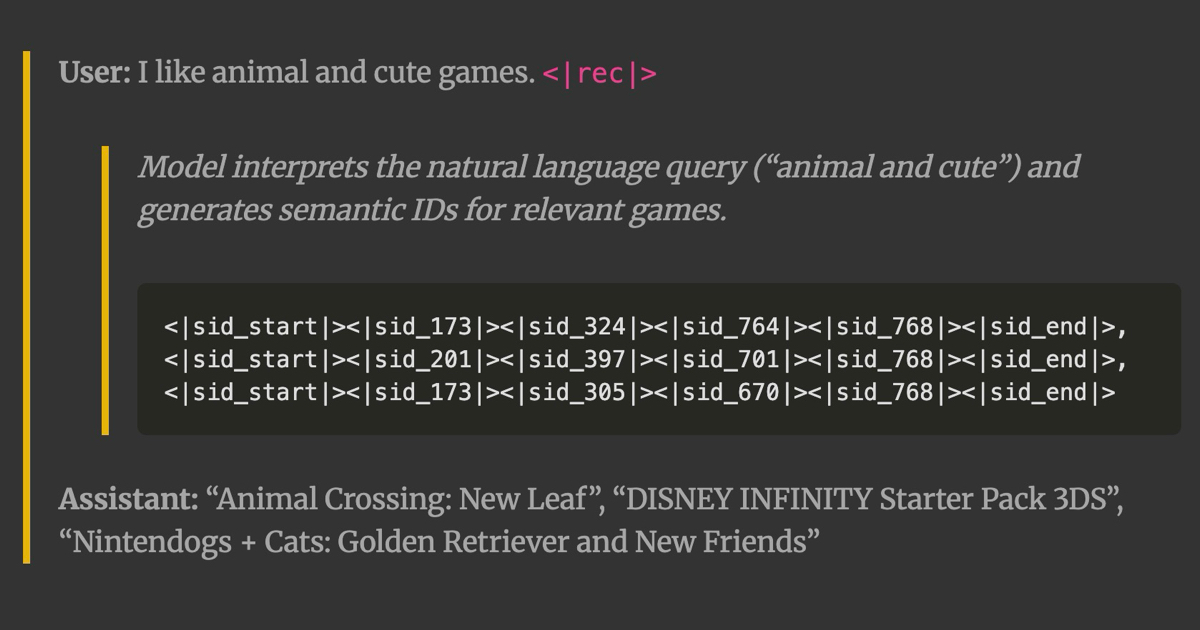
作者訓練一個結合大型語言模型與推薦系統的混合模型,利用語義 ID 讓模型能直接理解商品並進行推薦。讀者可學習如何將語義 ID 整合進語言模型,實現透過自然對話引導推薦結果,並理解相關技術細節。
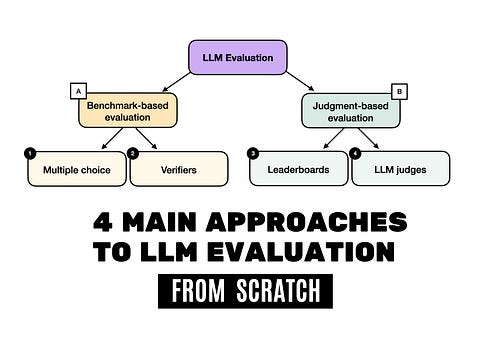
介紹評估大型語言模型的四大主流方法:多選題、驗證器、排行榜與 LLM 裁判,並提供從零開始的程式碼範例。讀者可透過這些實作了解不同評估方式的原理、優缺點與實際應用場景。
由 Andrej Karpathy 示範如何從零開始實現一個字級語言模型的多層感知機(MLP)。觀眾可以學習機器學習基礎概念,包括模型訓練、超參數調整、過擬合與驗證集分割等實務技巧。
※ 摘要僅根據標題與說明
Daniel Svonava 分享如何讓小型開源模型在生產環境中發揮 frontier 級效能,透過任務分割與專用模型組合降低成本。
Andrej Karpathy 手動演算反向傳播,深入理解梯度如何透過計算圖流動。透過實際演練,建立對神經網路最佳化原理的直覺與能力。
※ 摘要僅根據標題與說明