【TAICA_生成式AI:文字與圖像生成的原理與實務】4. LLM只是在猜下一個字
深入解析大型語言模型透過預測下一個字來生成文字與影像的原理,涵蓋從 RNN 到 Transformer 的演變、機率抽樣機制及提示詞技巧。觀眾能理解模型背後的數學核心,並學習如何設計有效提示詞以提升生成品質。
4,501次觀看
※ 摘要僅根據標題與說明
依發布時間
深入解析大型語言模型透過預測下一個字來生成文字與影像的原理,涵蓋從 RNN 到 Transformer 的演變、機率抽樣機制及提示詞技巧。觀眾能理解模型背後的數學核心,並學習如何設計有效提示詞以提升生成品質。
※ 摘要僅根據標題與說明
Elie Bakouch 展示 Claude Code 與 Codex 在 Optimizer Speedrun 中超越人類紀錄的表現,兩者策略迥異。影片探討自動 AI 研究現況與未來自進化路徑。
※ 摘要僅根據標題與說明
介紹 tokenizers v1 如何透過位元流分割、字詞快取與合併迴路重寫,將編碼速度提升數倍至數十倍。讀者可了解其最佳化原理與 Rust 實作細節,並掌握如何安裝與使用新版本。
OpenAI 研究員諾姆·布朗解析多智慧體系統如何透過並行思考解決千禧年大獎難題,並探討思維鏈監控的脆弱性與預訓練及強化學習的相乘效應。觀眾可了解 AI 加速演進的技術路徑、組織協作模式及未來安全挑戰。
訪談 Inception 創辦人 Stefano Ermon,探討他如何將擴散模型應用於文字與程式碼生成,並解釋為何擴散架構在推理速度上優於自迴歸模型。內容涵蓋從學術研究到商業化部署的經驗,以及未來 AI 競爭將由效率決定的觀點。
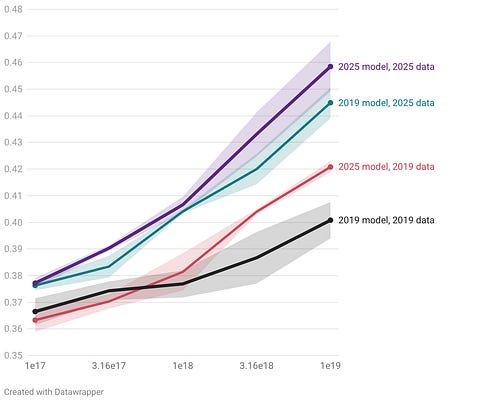
分析 2019 至 2025 年預訓練進度的資料與模型貢獻,發現資料最佳化帶來的效能提升遠高於模型架構改進。研究透過實作不同年份的模型配方與資料集,評估在 OLMES 指標下的表現,指出資料工程對小模型至關重要,而大模型則更能容納雜訊。
Hugo Bowne-Anderson 與 Sebastian Raschka 探討開放權重模型的重要性,指出其能避免對單一廠商的依賴並促進競爭。
訪談兩位頂尖 AI 研究學者,深入探討 2026 年 AI 發展現狀、規模定律、訓練流程及開源與閉源模型。內容涵蓋從基礎原理到職業建議,幫助讀者理解 AI 技術演進並規劃學習路徑。
分析 OpenAI 最新推出的 gpt-oss 系列開源大型語言模型架構,對比 GPT-2 與 Qwen3,解釋移除 Dropout、使用 RoPE、SwiGLU 等技術細節。
拆解大型語言模型如何從機率分佈選擇下一個字元,涵蓋貪婪解碼、Top-k、Top-p 及 Min-p 等策略。透過 GPT-2 實作示範,說明不同解碼方式如何影響輸出品質與創意。
※ 摘要僅根據標題與說明
李宏毅教授深入解析生成式 AI 的後訓練(Post-Training)與遺忘問題,說明如何為通用模型注入特定技能。課程探討了避免模型在學習新任務時遺忘原有能力的策略,並介紹了過濾難產生 Token 的技術。
Andrej Karpathy 深入解析大型語言模型(LLM)的訓練架構、心理機制與實際應用技巧。影片涵蓋從預訓練到後訓練的完整流程,幫助讀者理解模型運作原理並提升使用效率。
※ 摘要僅根據標題與說明
由 Andrej Karpathy 示範如何從零開始重現 GPT-2 (124M) 模型,涵蓋網路構建、訓練最佳化與實際運算過程。觀眾可學習如何建立大型語言模型並執行訓練。
※ 摘要僅根據標題與說明
整理一份語言模型領域的經典論文清單,每篇都附有一句話的核心摘要。讀者可以透過這份清單快速了解 Transformer、大型語言模型、提示工程及相關技術的關鍵概念,並建立自己的論文閱讀俱樂部。
由 Neel Nanda 解說 Transformer 架構的基本概念與運作原理,透過實作 GPT-2 示範如何從零開始理解模型內部機制。觀眾能掌握 Transformer 的核心邏輯,為深入學習機器學習奠定基礎。
※ 摘要僅根據標題與說明
由 Neel Nanda 講解如何從零實現 GPT-2,涵蓋 LayerNorm、嵌入、注意力機制與 MLP 等核心步驟。觀眾能透過影片掌握 Transformer 架構的實際程式設計與運作原理。
※ 摘要僅根據標題與說明
回顧 2018 年自然語言處理的突破性進展,介紹了 GPT、BERT、ELMo 等預訓練語言模型的架構與原理。讀者能理解無監督預訓練如何解決標籤資料需求,並掌握不同模型在下游任務中的應用方式。
依人氣
Andrej Karpathy 深入解析大型語言模型(LLM)的訓練架構、心理機制與實際應用技巧。影片涵蓋從預訓練到後訓練的完整流程,幫助讀者理解模型運作原理並提升使用效率。
※ 摘要僅根據標題與說明
由 Andrej Karpathy 示範如何從零開始重現 GPT-2 (124M) 模型,涵蓋網路構建、訓練最佳化與實際運算過程。觀眾可學習如何建立大型語言模型並執行訓練。
※ 摘要僅根據標題與說明
Elie Bakouch 展示 Claude Code 與 Codex 在 Optimizer Speedrun 中超越人類紀錄的表現,兩者策略迥異。影片探討自動 AI 研究現況與未來自進化路徑。
※ 摘要僅根據標題與說明
回顧 2018 年自然語言處理的突破性進展,介紹了 GPT、BERT、ELMo 等預訓練語言模型的架構與原理。讀者能理解無監督預訓練如何解決標籤資料需求,並掌握不同模型在下游任務中的應用方式。
整理一份語言模型領域的經典論文清單,每篇都附有一句話的核心摘要。讀者可以透過這份清單快速了解 Transformer、大型語言模型、提示工程及相關技術的關鍵概念,並建立自己的論文閱讀俱樂部。
分析 OpenAI 最新推出的 gpt-oss 系列開源大型語言模型架構,對比 GPT-2 與 Qwen3,解釋移除 Dropout、使用 RoPE、SwiGLU 等技術細節。
OpenAI 研究員諾姆·布朗解析多智慧體系統如何透過並行思考解決千禧年大獎難題,並探討思維鏈監控的脆弱性與預訓練及強化學習的相乘效應。觀眾可了解 AI 加速演進的技術路徑、組織協作模式及未來安全挑戰。
分析 2019 至 2025 年預訓練進度的資料與模型貢獻,發現資料最佳化帶來的效能提升遠高於模型架構改進。研究透過實作不同年份的模型配方與資料集,評估在 OLMES 指標下的表現,指出資料工程對小模型至關重要,而大模型則更能容納雜訊。
Hugo Bowne-Anderson 與 Sebastian Raschka 探討開放權重模型的重要性,指出其能避免對單一廠商的依賴並促進競爭。
訪談 Inception 創辦人 Stefano Ermon,探討他如何將擴散模型應用於文字與程式碼生成,並解釋為何擴散架構在推理速度上優於自迴歸模型。內容涵蓋從學術研究到商業化部署的經驗,以及未來 AI 競爭將由效率決定的觀點。