科技早餐 10/1|Anthropic IPO 文件示警,先進 AI 恐危及人類生存
科技早餐 10 月 1 日的五則新聞。彭博報導 OpenAI 正尋求募資至少 300 億美元、目標估值 1.4 兆美元;路透取得的 Anthropic 招股文件顯示去年營收是前一年的 12 倍、營業虧損仍超過 80 億美元,並警告先進…
依發布時間,最新的 30 筆
科技早餐 10 月 1 日的五則新聞。彭博報導 OpenAI 正尋求募資至少 300 億美元、目標估值 1.4 兆美元;路透取得的 Anthropic 招股文件顯示去年營收是前一年的 12 倍、營業虧損仍超過 80 億美元,並警告先進…
OpenAI 研究員諾姆·布朗解析多智慧體系統如何透過並行思考解決千禧年大獎難題,並探討思維鏈監控的脆弱性與預訓練及強化學習的相乘效應。觀眾可了解 AI 加速演進的技術路徑、組織協作模式及未來安全挑戰。
分享作者如何像訓練大模型一樣訓練自己,透過建立反饋迴圈與不斷推翻舊知識來適應 AI 進化。內容涵蓋從找需求、判斷能力與成本邊界,到最小驗證與重設計產品的完整流程,並提供個人實戰經驗與設計準則。
兩位 AI 安全研究員指出,大型語言模型返回的加密推理軌跡可被小型模型解讀並重放,導致隱私洩漏、提示注入與越獄攻擊。此漏洞影響多家供應商,顯示加密機制在 AI 系統中可能失效,需重新評估安全架構。
探討過度依賴 AI 寫作與學習可能導致思維退步與認知妥協的風險,並指出 AI 在特定情境下(如客製化教學)也能提升學習成效。文章強調應有選擇地使用 AI,避免將其作為解決問題的預設選項,以維持人類思考能力與真實性。
Samuel Rodriques 訪談 Edison Scientific 創辦人,探討如何用 AI 代理(Agents)解決藥物研發、腦部繪圖與衰老等難題。
Notion 創辦人 Simon Last 與 Sarah Sachs 分享 Custom Agents 經歷,說明因模型能力與權限設計而經歷多次重構,最終透過 Agent Lab 思維打造企業級代理系統。
Elad Gil 訪談 Liam Fedus,探討 Periodic Labs 如何利用大型語言模型與專用神經網路結合,建立連線物理世界的 AI 基礎實驗室。
討論語言模型雖能輔助研究,但受計算資源、人類監督與複雜度限制,無法實現自我加速的奇點。作者認為未來是「損耗性自我改進」,進度將呈線性而非指數增長,僅能提升效率而非引發劇變。
Altimeter 合夥人 Apoorv Agrawal 專訪 OpenAI 的 Nick Turley,談 ChatGPT 怎麼成為史上成長最快的產品之一、接下來要往哪裡走。
介紹上下文工程(Context Engineering)的概念,說明其與提示工程(Prompt Engineering)的異同,並探討如何透過最佳化輸入讓語言模型獲得預期輸出。
探討如何透過微調重排序模型與嵌入模型,將 RAG 檢索效能提升約 12%,並分析 ColBERT 架構與硬負例訓練的實作細節。讀者可學習如何平衡延遲與準確性,針對特定領域資料進行最佳化。
OpenAI 副總裁 Brad Lightcap 與首席經濟學家 Ronnie Chatterji 探討 AI 對工作、教育及經濟的衝擊。
張祥雨分享多模態研究十年歷程,剖析模型推理能力與規模反相關現象,並提出引入思維鏈(CoT)解決生成與理解割裂的觀點。內容涵蓋從 ResNet 到 NAS 的學術演進,以及對未來 AGI 與多模態融合架構的預見。
深入探討大型語言模型訓練中「預訓練」與「對齊」的強大與極限,指出預訓練奠定基礎能力,而對齊僅需少量高品質資料進行畫龍點睛的微調。
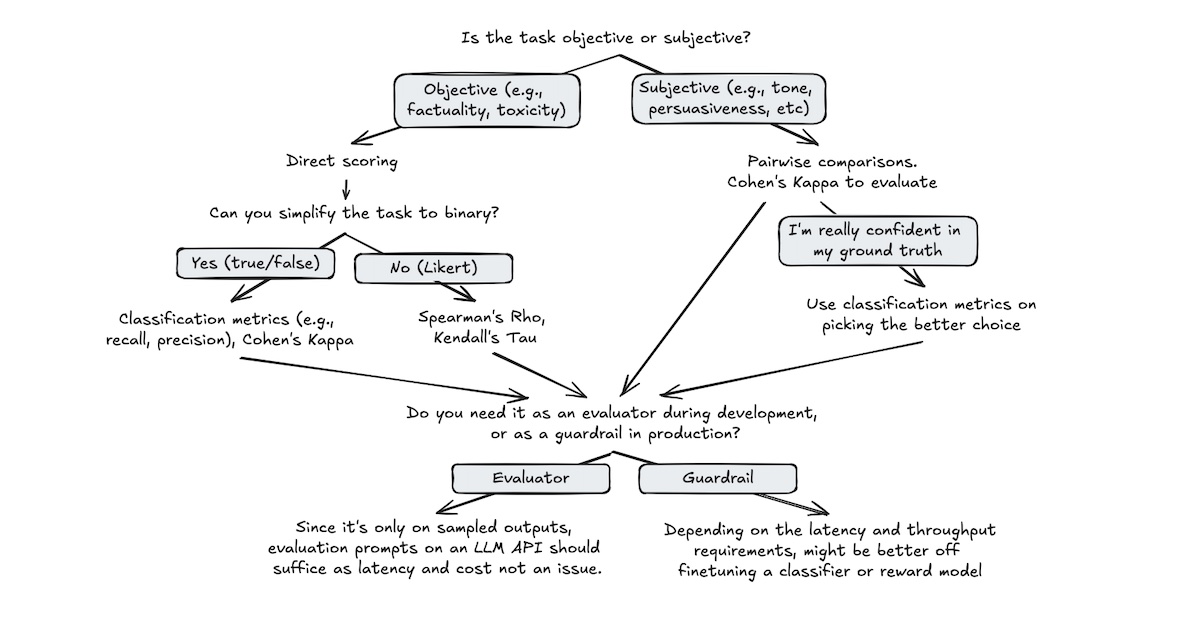
介紹將大型語言模型用作評估者(LLM-as-Judge)的技術、應用與挑戰,涵蓋直接評分、兩兩比較與參考基準等評分方法,並討論了相關評估指標與最佳實踐。讀者可學習如何設計、部署與最佳化 LLM 評估系統,以自動化評估其他模型的品質。
由 Eugene Yan 撰寫,深入探討大型語言模型提示工程的核心基礎與實作技巧。文章涵蓋結構化輸入輸出、思維鏈、n-shot 提示等概念,並提供使用 Claude API 的程式碼範例,教導讀者如何透過角色設定、評估機制與參數調整來最佳…
探討生成式 AI 中文字接龍與畫素接龍的生成策略差異,解釋為何影像與語音多採用非自迴歸方式。觀眾可了解不同基本單位(Token、Pixel、Sample)的組合邏輯,並掌握自迴歸與非自迴歸模型的優缺點及結合應用。
介紹 Speculative Decoding 技術,透過預言家預測語言模型接下來要生成的 Token,讓模型能平行計算,大幅加速生成速度。
深入探討大型語言模型面臨的欺騙風險,區分「越獄」與「提示注入」兩種攻擊手法。透過實際範例與最新研究,說明如何繞過模型防禦機制,並提醒使用者注意潛在的隱私洩漏與安全隱患。
介紹如何評估大型語言模型的能力,涵蓋選擇題、翻譯、長文閱讀等任務的評比方法。內容指出傳統基準如 MMLU、BLEU 存在缺陷,並探討模型可能偷看訓練資料的現象,提供更客觀的評估視角。
探討大型語言模型的安全議題,包括幻覺問題、事實查核機制、偏見檢測方法以及利用浮水印驗證生成內容。觀眾可學習如何評估模型可靠性、檢測潛在偏見及辨識 AI 生成文字。
李宏毅教授探討大型語言模型的可解釋性,透過實作實驗與理論分析,說明如何判斷模型是否透明、可解讀及可解釋。課程涵蓋開源與閉源模型的差異、探針分析(probing)方法、信心分數評估,以及模型可能編造解釋的風險,幫助讀者理解當前 AI 黑盒的…
介紹大型語言模型如何演變為能自主規劃與執行多步驟任務的 AI Agent,並透過記憶與反思機制提升能力。內容涵蓋從虛擬世界到實體機器人的應用案例,說明 AI Agent 如何根據環境變化調整計畫與累積經驗。
詳細介紹大型語言模型訓練的第三階段 RLHF,透過人類回饋調整模型行為。內容涵蓋 RLHF 與指令微調的差異、PPO 演算法原理、回饋模型訓練方式,以及安全與有用性的權衡問題。
李宏毅教授以《葬送的芙莉蓮》中角色合作對抗複製體的劇情為例,闡述讓多個語言模型彼此討論而非單獨運作的概念。透過實際示範,展示不同模型如何互相提問與修正,激發比單一模型更強的推理能力,並探討未來建立由 AI 組成的虛擬團隊的可能性。
介紹在不重新訓練語言模型的情況下,透過拆解複雜任務、自我反省、多次嘗試及使用外部工具來增強模型能力。觀眾能學習 Chain of Thought、Self Consistency 與 Tree of Thought 等技術原理與實際應用方…
探討在不訓練模型的情況下,如何透過特定提示技巧(如 Chain of Thought、情緒勒索)與提供額外資訊(In-context Learning)來強化大型語言模型的能力。
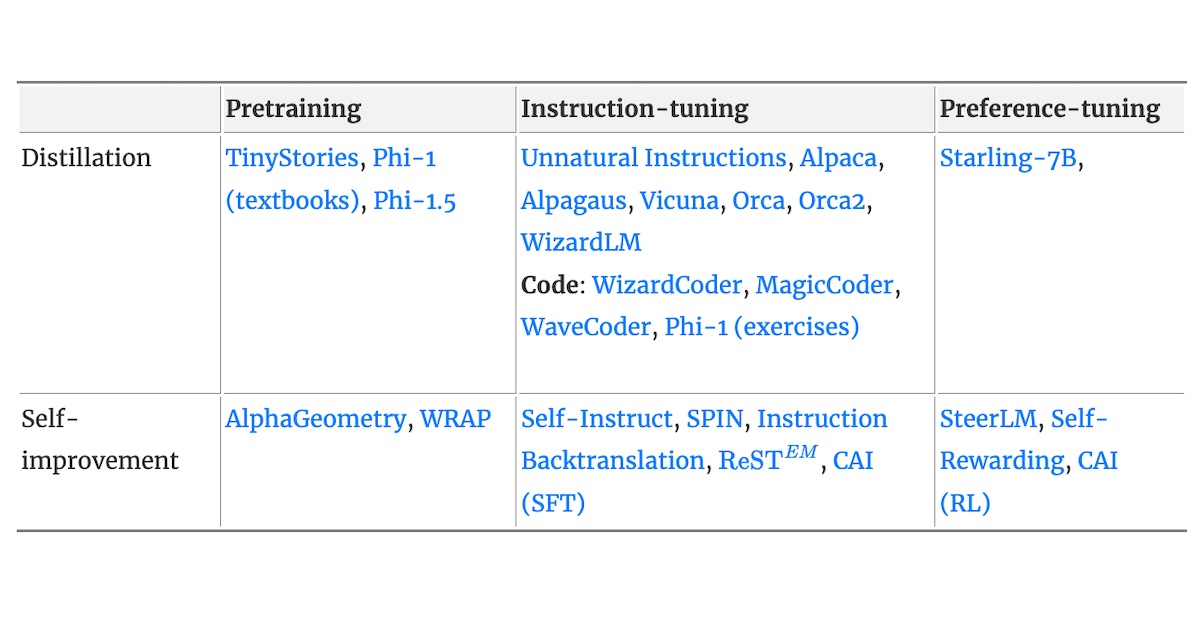
介紹如何利用合成資料進行預訓練、指令調優與偏好調優,涵蓋知識蒸餾與自我改進兩種主要方法。讀者可學習如何生成高品質資料以提升模型表現,並了解相關技術細節與評估方式。
深入探討大型語言模型(LLM)面臨的對抗性攻擊,包括白盒與黑盒攻擊方法,如 Token 操作、梯度下降及 Jailbreak 提示。讀者可了解攻擊原理、現有防禦機制(如對抗訓練)及其限制,並掌握相關研究架構。
依人氣
OpenAI 副總裁 Brad Lightcap 與首席經濟學家 Ronnie Chatterji 探討 AI 對工作、教育及經濟的衝擊。
深入探討大型語言模型(LLM)面臨的對抗性攻擊,包括白盒與黑盒攻擊方法,如 Token 操作、梯度下降及 Jailbreak 提示。讀者可了解攻擊原理、現有防禦機制(如對抗訓練)及其限制,並掌握相關研究架構。
Eugene Yan 分享建構大型語言模型系統的四個關鍵構件:評估、檢索增強生成、防護欄與回饋收集。文章強調應針對特定任務建立簡化評估,善用現有資訊檢索技術,並重視使用者體驗以收集有效回饋。
分享作者如何像訓練大模型一樣訓練自己,透過建立反饋迴圈與不斷推翻舊知識來適應 AI 進化。內容涵蓋從找需求、判斷能力與成本邊界,到最小驗證與重設計產品的完整流程,並提供個人實戰經驗與設計準則。
介紹如何利用合成資料進行預訓練、指令調優與偏好調優,涵蓋知識蒸餾與自我改進兩種主要方法。讀者可學習如何生成高品質資料以提升模型表現,並了解相關技術細節與評估方式。
探討過度依賴 AI 寫作與學習可能導致思維退步與認知妥協的風險,並指出 AI 在特定情境下(如客製化教學)也能提升學習成效。文章強調應有選擇地使用 AI,避免將其作為解決問題的預設選項,以維持人類思考能力與真實性。
討論語言模型雖能輔助研究,但受計算資源、人類監督與複雜度限制,無法實現自我加速的奇點。作者認為未來是「損耗性自我改進」,進度將呈線性而非指數增長,僅能提升效率而非引發劇變。
介紹將大型語言模型用作評估者(LLM-as-Judge)的技術、應用與挑戰,涵蓋直接評分、兩兩比較與參考基準等評分方法,並討論了相關評估指標與最佳實踐。讀者可學習如何設計、部署與最佳化 LLM 評估系統,以自動化評估其他模型的品質。
區分「提示工程」與「盲目試錯」,透過建立示範集、設計候選提示詞、系統性測試與成本效益分析,展示如何將提示工程應用於實際專案。讀者能學習如何將自然語言輸入轉為結構化資料的工程化流程,並掌握驗證與持續改進的方法。
由 Eugene Yan 撰寫,深入探討大型語言模型提示工程的核心基礎與實作技巧。文章涵蓋結構化輸入輸出、思維鏈、n-shot 提示等概念,並提供使用 Claude API 的程式碼範例,教導讀者如何透過角色設定、評估機制與參數調整來最佳…