AI 模型越便宜反而越花錢?史丹佛等機構研究:近 1/3 模型成本比較出現「反轉」
史丹佛大學等機構研究發現,API 單價較低的 AI 模型在實際任務中可能因過度推理或執行而產生更高成本,約三成案例出現價格逆轉。
22 筆內容提到
最近 7 天 2 筆新上榜(前一期沒有,這一期新出現)(再前 7 天 0 筆)
也寫作:GPT 5.4
這一頁列的是「提到 GPT-5.4」的內容(名稱由語言模型從內容裡整理),不一定整筆都在講它。只想追它的新內容:訂閱 RSS;想找標題裡就有它的:搜尋「GPT-5.4」。
依發布時間
史丹佛大學等機構研究發現,API 單價較低的 AI 模型在實際任務中可能因過度推理或執行而產生更高成本,約三成案例出現價格逆轉。
透過 ThinkingBox 環境,評估 AI 代理在執行資料庫操作時的真實一致性,發現僅看工具呼叫次數無法反映最終結果。研究指出,許多代理雖然報告成功,但資料庫狀態卻未達預期,導致任務失敗。
基於 TypeSafe 創辦人 Diogo Almeida 的設計筆記,探討若大模型無 KV Cache 時如何重構編碼智慧體。
OpenAI 大幅降低 GPT-5.6 價格並推出低延遲 Sol Fast 層,同時 Inkling-Small 推出小規模多模態模型,Gemini Robotics 2 實現全身機器人控制。
探討 tokenmaxxing 策略因模型漲價與訂閱制不可持續而失靈,並介紹 Claude Fable 5 與 Mythos 5 的發布與計費變化。讀者可了解 AI 成本趨勢、新模型特性及訂閱與 API 計費的差異。
本週文章回顧 OpenAI 最新發布的 GPT-5.5 與 GPT-Image-2.0 模型特性,並深入解析 DeepSeek-V4 的技術亮點與價格策略。讀者可掌握最新大模型在程式編寫、影像生成及長上下文處理上的實際表現與應用場景。
深入解析 DeepSeek V4 模型的訓練架構與技術創新,涵蓋 MHC 殘差連線、Muon 最佳化器及專家訓練等新範式,並對比其與 Claude Opus 及 GPT-5.4 的優劣。
※ 摘要僅根據標題與說明
深入解析 Moonshot AI 的開源模型 Kimi K2.6,並與 GPT-5.4 及 Claude Opus 進行 benchmarks 比對。
※ 摘要僅根據標題與說明
Nick Saraev 評論 Anthropic 新發布的 Opus-4.7 模型,指出其在軟體工程與視覺推理等指標上顯著進步,但代理終端編碼與搜尋能力因安全考量被刻意削弱。
探討 AI 安全新經濟,指出防禦者需投入比攻擊者更多的計算資源(Token)才能確保系統安全。透過 AISI 測試顯示,Anthropic 的 Mythos 模型在模擬企業網路攻擊中表現卓越,驗證了「投入更多 Token 發現漏洞」的防禦…
比較 MiniMax M2.7 與 GPT 5.4 在實際程式開發任務中的表現,涵蓋前端重構、物理模擬與框架遷移。透過真實工作流測試,展示兩者在程式碼能力上的差距與 MiniMax 的定價優勢。
※ 摘要僅根據標題與說明
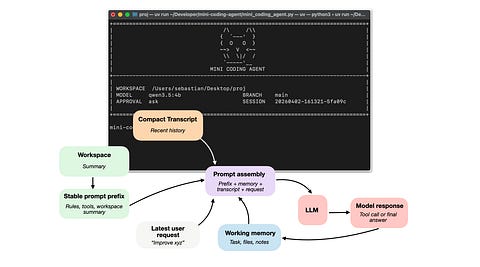
深入解析編碼代理(Coding Agent)的六個核心元件,包括即時專案上下文、提示詞快取、結構化工具、上下文壓縮、記憶與恢復,以及子代理委託。
Simon Willison 在訪談中分享 AI 程式設計代理如何於 2025 年 11 月成為分水嶺,讓他能靠手機寫出大量程式碼。他探討了「暗工廠」模式、AI 安全風險及當前使用的工具。
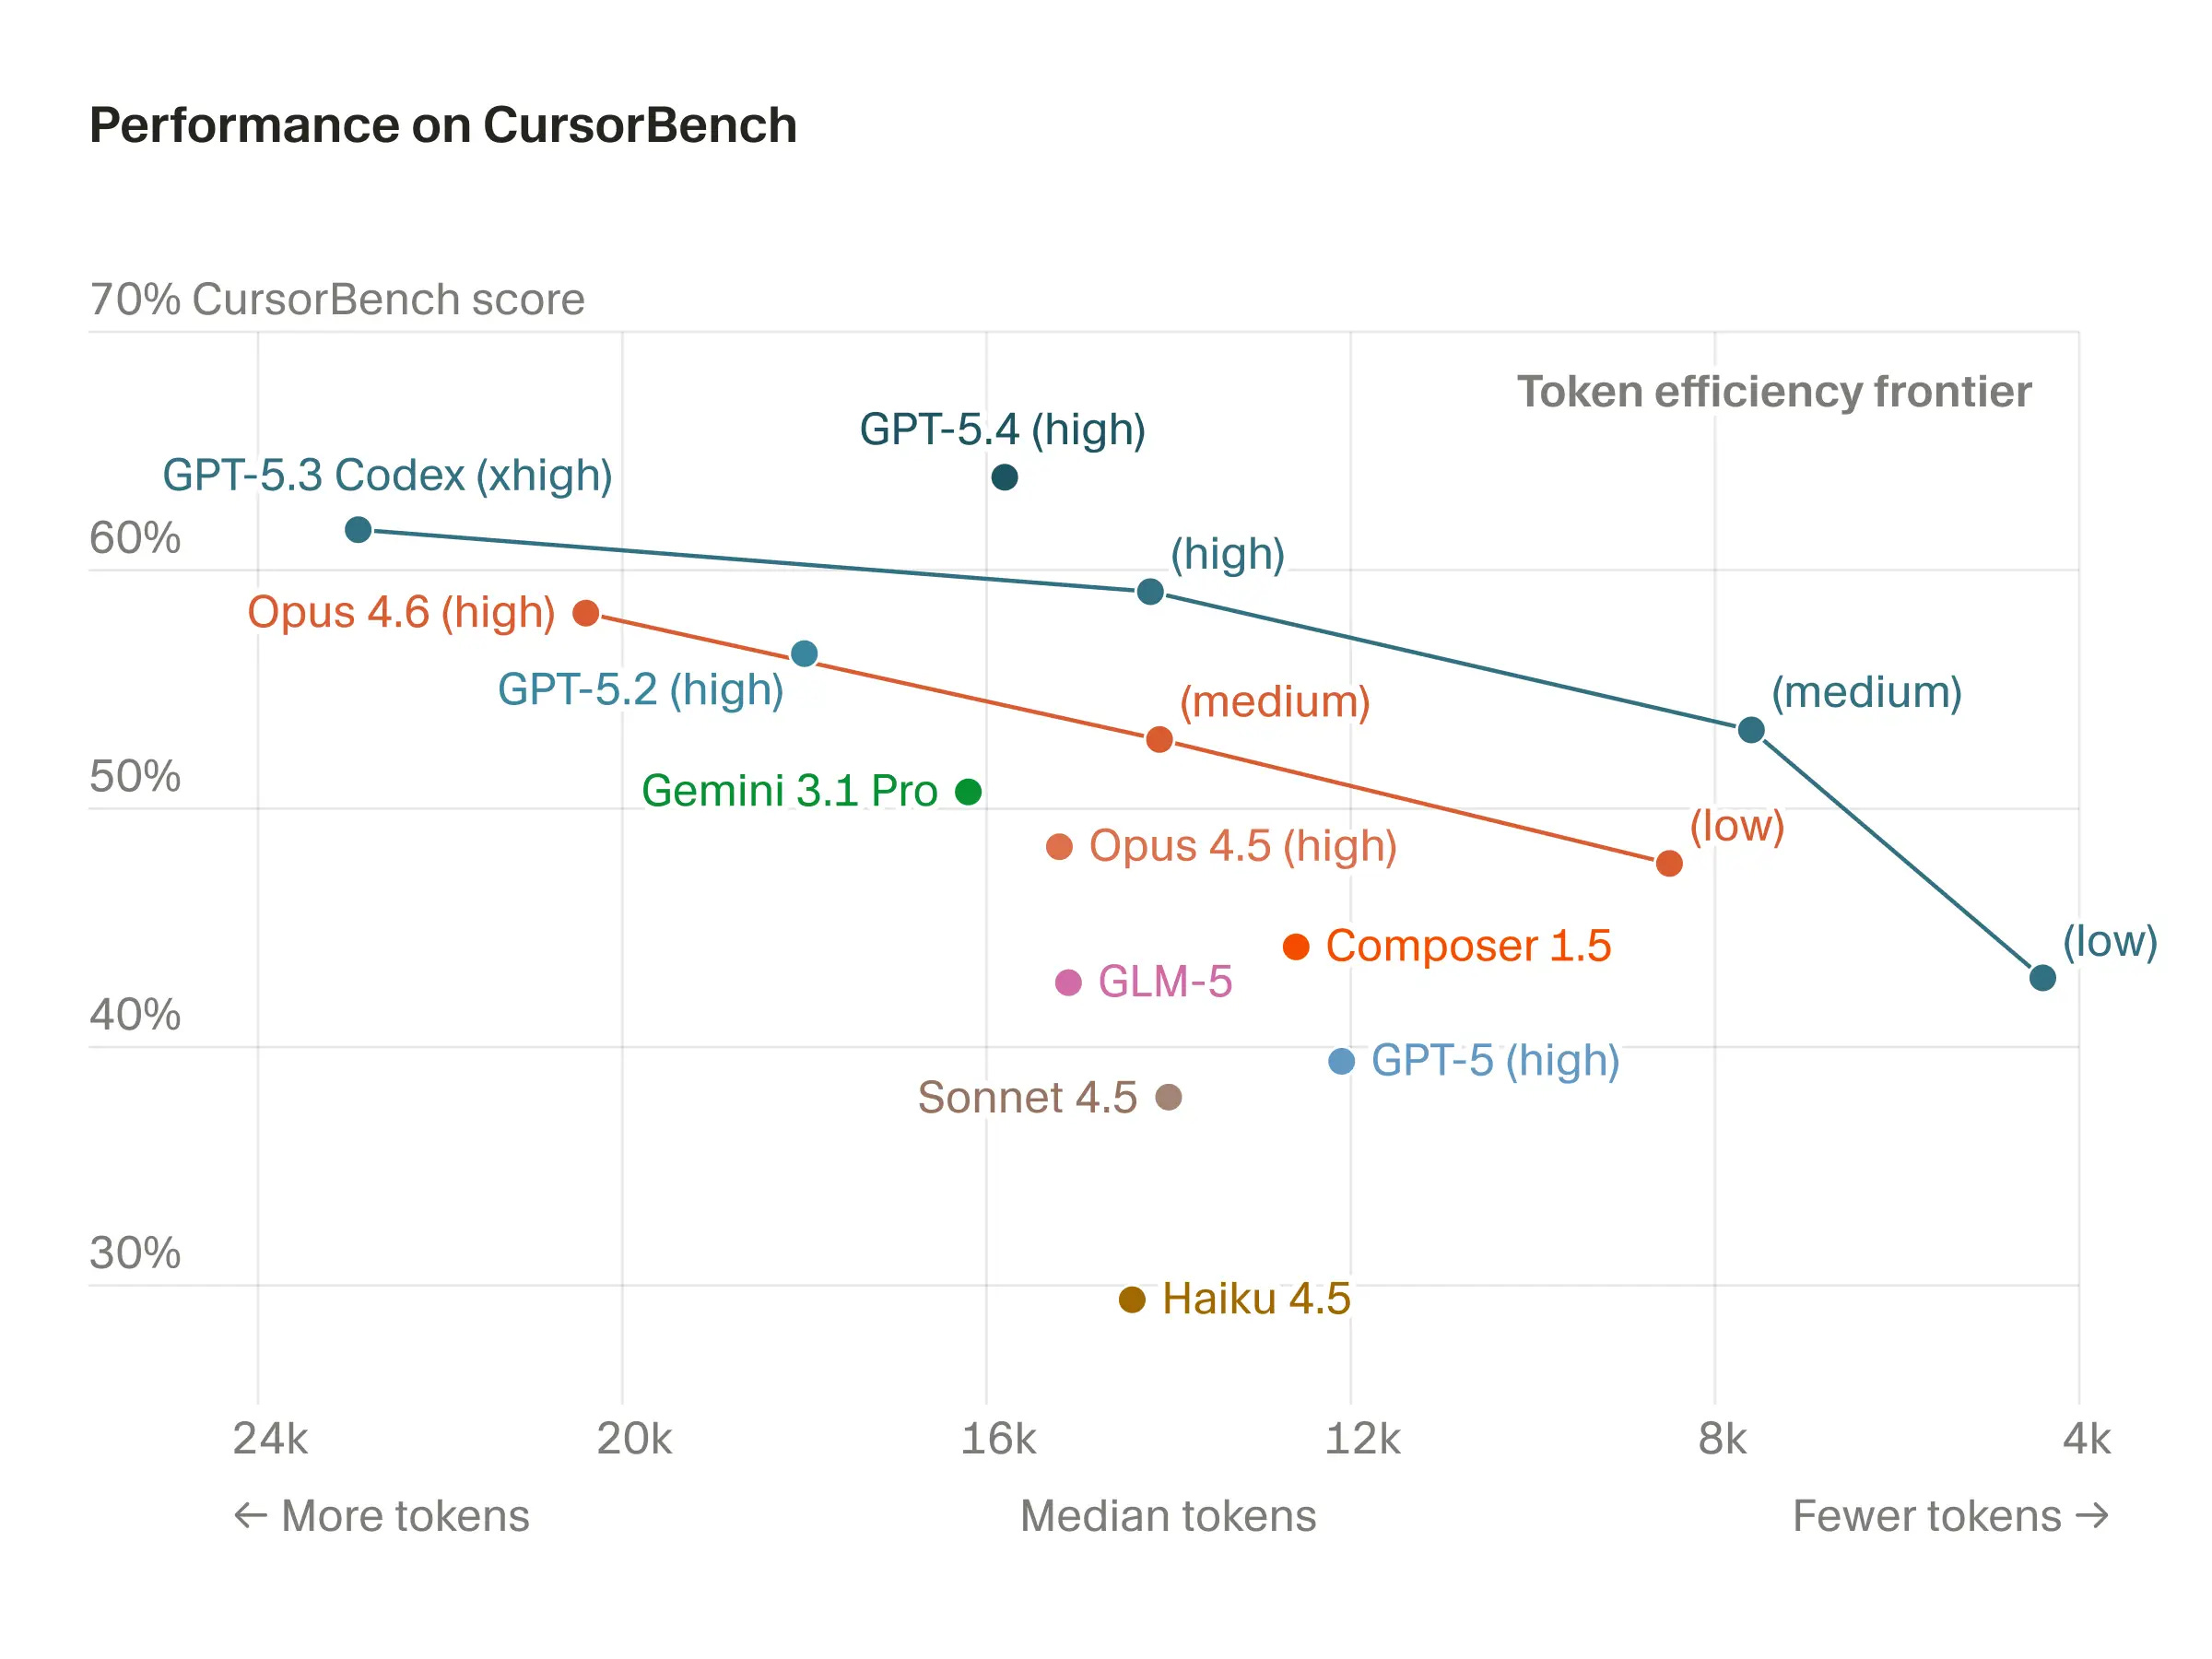
深入評測 GPT 5.4 在 Codex 中的表現,認為其相比前代在易用性、速度與成本上都有實質進步。內容探討了傳統評測指標的侷限,並對比了 GPT 5.4 與 Claude 在執行指令與風格上的差異,指出前者更適合處理大量具體任務。
分享如何透過三次迭代,將純向量搜尋與詞彙搜尋結合,解決搜尋關鍵字遺漏問題。文章詳細記錄了從架構設計、生產環境延遲故障到最終統一搜尋 Worker 的完整過程,並分享使用 Cursor 與 GPT-5.4 進行開發與重構的經驗。
探討開放模型在 2026 年的未來走向,指出其將分為三個類別:真正的前端閉源模型、效能與價格平衡的開放前端模型,以及作為分散式智慧的開放小型模型。
聚焦 AI 智慧體技術演進與消費級應用趨勢,涵蓋 GPT-5.4 效能突破、OpenClaw 爆發式增長及 Agent 工程化實踐。文章深入探討 AI 如何重塑軟體開發、產品設計與行業競爭格局,並分析多模態模型最佳化與市場變革。
涵蓋 OpenAI 推出程式設計優異的 GPT-5.4 模型、人腦玩電玩、AI 程式碼助手的安全風險,並介紹 Handy 語音轉文字與網頁震動等新工具。
探討「數字員工」概念,區分於現有工具,定義為能自主執行長程任務的 AI Agent。作者透過算力、硬體與電力三種方法估算,認為當前全球僅能支撐約 680 萬個數字員工,並分析其效能取決於任務型別與 API 化程度。
探討 AI 工具(如「龍蝦」)不應僅靠安裝,而需依賴清晰的任務場景與 SOP 流程才能發揮價值。作者指出,缺乏實際工作場景的人不應焦慮,並建議透過付費使用 Claude Code 或 GPT 5.4 來體驗 AI 解決具體問題的真實效能。
分析 OpenAI 最新發布的 GPT 5.4 模型,探討其在白領工作模擬測試中的表現、程式設計與檔案處理能力的進步,以及模型在特定領域表現不穩定的「尖刺」現象。
主持人與嘉賓討論 OpenAI 最新推出的 GPT-5.4 模型,分析其推理能力、價格與工具呼叫優勢,並展示他們用單個提示詞重建的 Microsoft Teams 與 Trello 應用程式。
依人氣
Simon Willison 在訪談中分享 AI 程式設計代理如何於 2025 年 11 月成為分水嶺,讓他能靠手機寫出大量程式碼。他探討了「暗工廠」模式、AI 安全風險及當前使用的工具。
聚焦 AI 智慧體技術演進與消費級應用趨勢,涵蓋 GPT-5.4 效能突破、OpenClaw 爆發式增長及 Agent 工程化實踐。文章深入探討 AI 如何重塑軟體開發、產品設計與行業競爭格局,並分析多模態模型最佳化與市場變革。
探討 AI 工具(如「龍蝦」)不應僅靠安裝,而需依賴清晰的任務場景與 SOP 流程才能發揮價值。作者指出,缺乏實際工作場景的人不應焦慮,並建議透過付費使用 Claude Code 或 GPT 5.4 來體驗 AI 解決具體問題的真實效能。
探討「數字員工」概念,區分於現有工具,定義為能自主執行長程任務的 AI Agent。作者透過算力、硬體與電力三種方法估算,認為當前全球僅能支撐約 680 萬個數字員工,並分析其效能取決於任務型別與 API 化程度。
本週文章回顧 OpenAI 最新發布的 GPT-5.5 與 GPT-Image-2.0 模型特性,並深入解析 DeepSeek-V4 的技術亮點與價格策略。讀者可掌握最新大模型在程式編寫、影像生成及長上下文處理上的實際表現與應用場景。
基於 TypeSafe 創辦人 Diogo Almeida 的設計筆記,探討若大模型無 KV Cache 時如何重構編碼智慧體。
探討 AI 安全新經濟,指出防禦者需投入比攻擊者更多的計算資源(Token)才能確保系統安全。透過 AISI 測試顯示,Anthropic 的 Mythos 模型在模擬企業網路攻擊中表現卓越,驗證了「投入更多 Token 發現漏洞」的防禦…
深入解析編碼代理(Coding Agent)的六個核心元件,包括即時專案上下文、提示詞快取、結構化工具、上下文壓縮、記憶與恢復,以及子代理委託。
Nick Saraev 評論 Anthropic 新發布的 Opus-4.7 模型,指出其在軟體工程與視覺推理等指標上顯著進步,但代理終端編碼與搜尋能力因安全考量被刻意削弱。
分析 OpenAI 最新發布的 GPT 5.4 模型,探討其在白領工作模擬測試中的表現、程式設計與檔案處理能力的進步,以及模型在特定領域表現不穩定的「尖刺」現象。