The next generation of voice AI with Google DeepMind and Sierra AI(在新分頁開啟原站)
Google DeepMind 與 Sierra AI 的 Valeria Wu 與 Soham Ray 探討了原生音訊模型的最新進展,並分析了如何建構更佳的即時語音體驗。
2.1 萬次觀看
※ 摘要僅根據標題與說明
Speech & Audio ・ 30 筆內容
語音辨識、語音合成與語音 agent。
也叫做:語音辨識、语音识别、語音合成、语音合成、TTS、ASR、speech recognition、text to speech、voice agent、voice agents、Whisper、語音助理
由淺入深:入門 → 進階 → 高階
Simon Willison's Weblog● 有原文
The world of voice AI, with Mati Staniszewski of ElevenLabs
Cheeky Pint1 小時● 有原文
Introducing gpt-transcribe and gpt-live-transcribe(在新分頁開啟原站)
OpenAI2 分鐘○ 無原文
From Voice Agents to AI Avatars with Alexander Smola - #777
The TWIML AI Podcast1 小時 5 分● 有原文
The Open ASR Leaderboard Adds Its First Global South Language
Hugging Face Blog● 有原文
The next generation of voice AI with Google DeepMind and Sierra AI(在新分頁開啟原站)
Google for Developers5 分鐘○ 無原文
Speech Recognition Is Not a Solved Problem — Pavan Kumar Reddy(在新分頁開啟原站)
Machine Learning Street Talk1 小時 42 分○ 無原文
Measuring benchmark optimization in speech recognition
Hugging Face Blog● 有原文
依相關、人氣、新鮮度綜合排序;站長推薦的加成
Google DeepMind 與 Sierra AI 的 Valeria Wu 與 Soham Ray 探討了原生音訊模型的最新進展,並分析了如何建構更佳的即時語音體驗。
※ 摘要僅根據標題與說明
Alexander Smola 探討從語音代理到具身 AI 的演進,指出即時語音雖進步顯著,但自然對話仍面臨高門檻。他強調情感智慧與多模態互動是未來關鍵,並分享在嘈雜環境下測試的經驗,認為未來幾個月內語音將更穩定,機器人將開始廣泛應用。
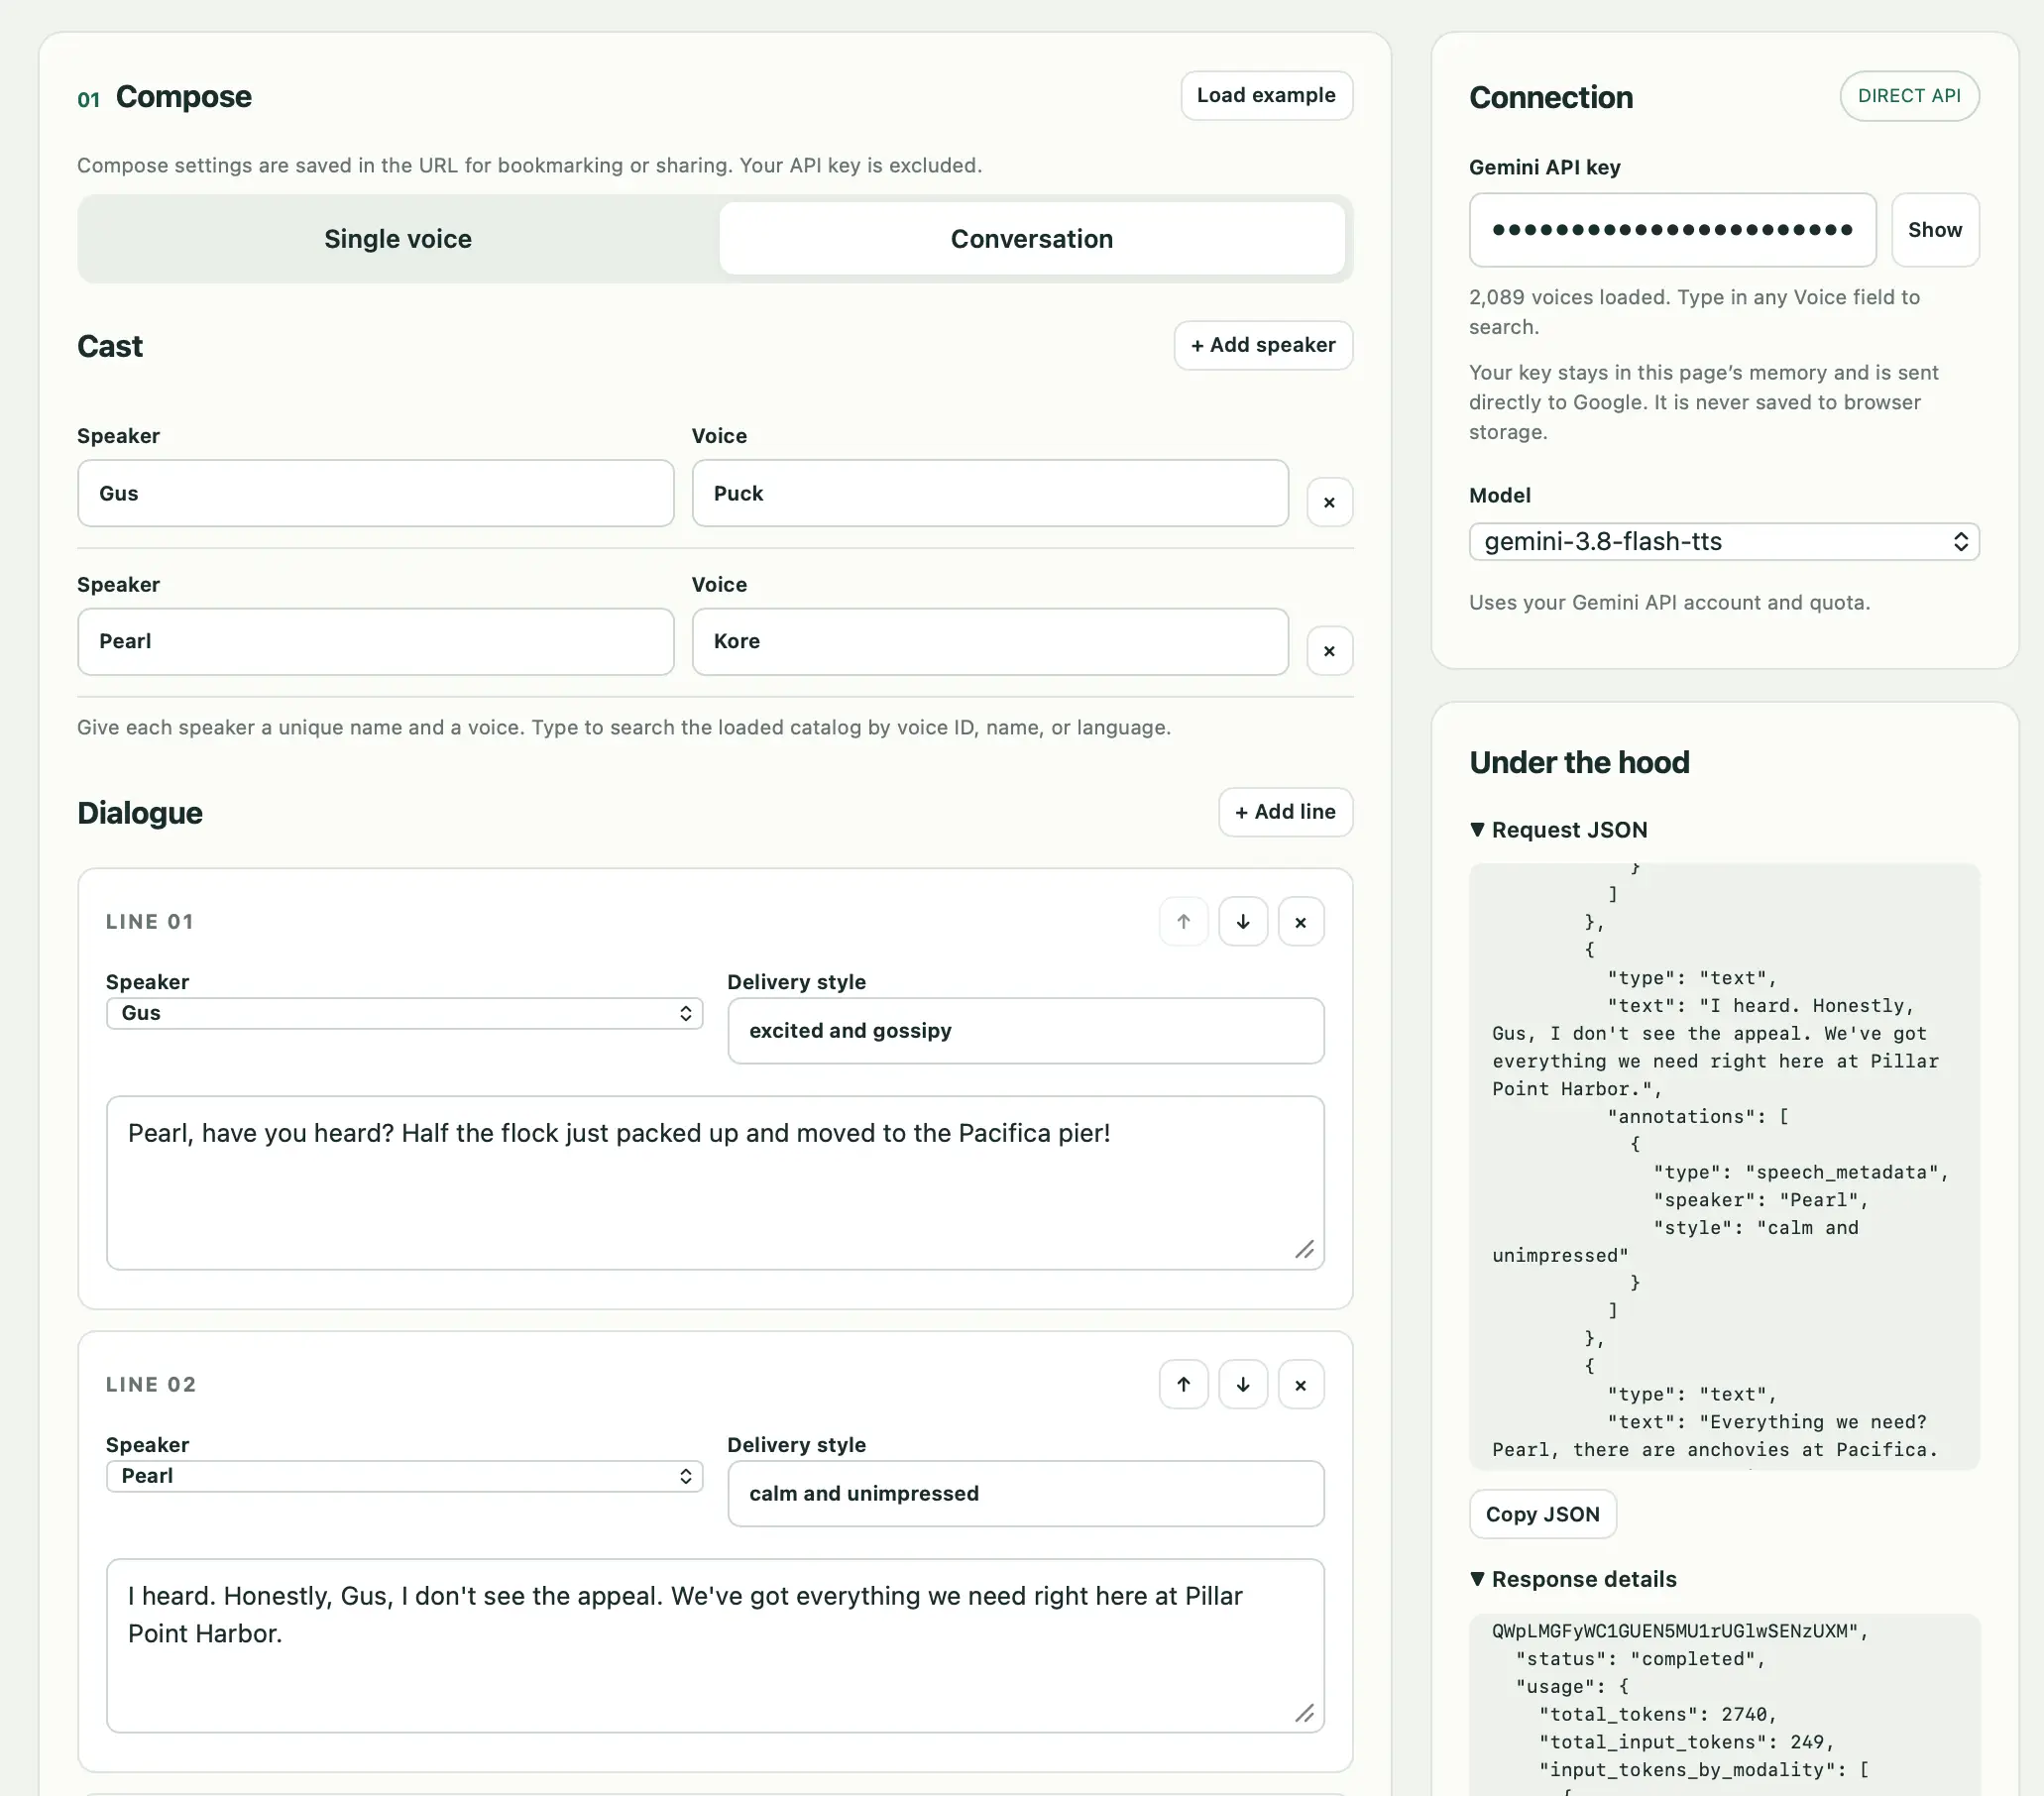
介紹了 Google 推出的 Gemini 3.8 Flash TTS 與 Flash Lite TTS 模型,提供超過 2000 種語音選擇,並支援使用者自定義語音。
介紹了兩個新工具:gpt-transcribe 用於將文字轉為語音,以及 gpt-live-transcribe 用於即時轉寫會議內容。
※ 摘要僅根據標題與說明
介紹了 Open TTS Leaderboard,旨在解決開放源 TTS 模型評測碎片化問題。該板塊使用視覺化指標(如 WER、RTFx、SIM)替代傳統的人工偏好評分,讓評測更快速且具可比性。
介紹 Google 推出的 Gemini 3.8 Flash TTS 新特性,包括支援 2000 多語音庫、可進行語音克隆與 Guardrails 控制,並提供多語者對話與長時音訊的示範。
※ 摘要僅根據標題與說明
探討了語音識別中「benchmark 最佳化」現象,即模型傾向於重現參考資料集中的錯誤或特定拼寫,而非準確聽寫。研究透過三項測試(共識分歧探測、掩碼數字測試、正字法切換測試)量化此問題,發現部分模型會根據參考資料的音訊特徵或拼寫習慣調整輸…
Rime Labs 由語言學專家創立,提供近 600 個跨 10 種語言的方言聲音,涵蓋墨西哥、哥倫比亞等地特色。該平台已與麥高診所及 Dialpad 合作,展現在語音合成上的專業實力。
※ 摘要僅根據標題與說明
OpenAI 推出 Codex Voice,功能類似 Jarvis,主要用於語音指令控制,但需配合特定軟體使用。
※ 摘要僅根據標題與說明
介紹 NVIDIA Magpie TTS,一款支援 12 種語言的開放權重多語音合成模型。透過自定義部署架構,使用者可完全掌控延遲,並針對自家硬體最佳化效能。
Pavan Kumar Reddy 與 Tim Scarfe 探討 Voxtral 架構,說明其如何透過直接嵌入與雙流解碼器實現即時語音轉文字,並分析為何端到端系統尚未完全解決。
※ 摘要僅根據標題與說明
這則影片教導如何從零開始建立一個能實際運作的 AI 語音代理,讓使用者能像真人接聽員一樣處理電話。
※ 摘要僅根據標題與說明
Mati Staniszewski 與 John Collison 探討了 ElevenLabs 的語音 AI 技術,包括如何從波形和音素層面模擬人類聲音,以及為何這種方法能產生更真實的情感表達。
※ 摘要僅根據標題與說明
Open ASR Leaderboard 新增印度英語與印地語兩個全球南方語言測試集,透過詳細的地理、人口與裝置資訊,讓讀者能追蹤模型在不同區域與口音下的準確率差異。
本教學介紹如何使用 JavaScript 原生的 Web Speech API 實現語音轉文字功能。內容涵蓋 API 簡介、物件建立、語言設定、啟動偵測及結果取得等步驟,讓讀者掌握基本語音辨識實作。
※ 摘要僅根據標題與說明
介紹了 Ashwyn Sharma 如何打造能自動識別並回應使用者語音的應用程式介面,讓使用者無需打字即可與系統互動。
※ 摘要僅根據標題與說明
探討開發通用音訊基礎模型的挑戰,由 CUHK 的 Dongchao Yang 提出。
※ 摘要僅根據標題與說明
介紹了 NeuralAudioCodecs 的近期進展,並透過 SemantiCodec 案例說明其應用。
※ 摘要僅根據標題與說明
本訪談介紹了 Mistral 推出的 Voxtral TTS 模型,該模型在開源權重與研究貢獻上均達至 ElevenLabs 水平。
※ 摘要僅根據標題與說明
Higgs Avatar v1 憑藉單一圖片即可生成具備即時語音、口型同步及表情變化的數位人形,實現即時對話。
※ 摘要僅根據標題與說明
本影片由 UIUC 的 Minje Kim 主講,探討神經語言通訊編碼(Neural Speech Communication Codecs)的未來方向,內容聚焦於技術演進與應用前景。
※ 摘要僅根據標題與說明
※ 摘要僅根據標題與說明
Meta 的 Shang-Wen Li 在影片中指出,Zero-Shot Speech Editing 與 TTS 技術已在真實世界應用中展現潛力,並探討其具體實現方式。
※ 摘要僅根據標題與說明
依發布時間
介紹了 Open TTS Leaderboard,旨在解決開放源 TTS 模型評測碎片化問題。該板塊使用視覺化指標(如 WER、RTFx、SIM)替代傳統的人工偏好評分,讓評測更快速且具可比性。
Google DeepMind 與 Sierra AI 的 Valeria Wu 與 Soham Ray 探討了原生音訊模型的最新進展,並分析了如何建構更佳的即時語音體驗。
※ 摘要僅根據標題與說明
介紹 Google 推出的 Gemini 3.8 Flash TTS 新特性,包括支援 2000 多語音庫、可進行語音克隆與 Guardrails 控制,並提供多語者對話與長時音訊的示範。
※ 摘要僅根據標題與說明
介紹了 Google 推出的 Gemini 3.8 Flash TTS 與 Flash Lite TTS 模型,提供超過 2000 種語音選擇,並支援使用者自定義語音。
OpenAI 推出 ChatGPT Voice,支援透過語音指令操作郵件、排程與 Slack 等外掛,並由 GPT-6 Astra、Sol 及 Luna 模型驅動,可在網頁與手機上直接進行撰寫與複雜任務處理。
※ 摘要僅根據標題與說明
SLNG.ai 推出 MIT 授權的 Unmute 標準,解決 AI 語音代理因平台差異導致的不穩定問題。該標準透過明確定義執行流程與工具呼叫,確保語音代理在不同系統間可移植且行為可預測。
※ 摘要僅根據標題與說明
Alexander Smola 探討從語音代理到具身 AI 的演進,指出即時語音雖進步顯著,但自然對話仍面臨高門檻。他強調情感智慧與多模態互動是未來關鍵,並分享在嘈雜環境下測試的經驗,認為未來幾個月內語音將更穩定,機器人將開始廣泛應用。
※ 摘要僅根據標題與說明
Pavan Kumar Reddy 與 Tim Scarfe 探討 Voxtral 架構,說明其如何透過直接嵌入與雙流解碼器實現即時語音轉文字,並分析為何端到端系統尚未完全解決。
※ 摘要僅根據標題與說明
Rime Labs 由語言學專家創立,提供近 600 個跨 10 種語言的方言聲音,涵蓋墨西哥、哥倫比亞等地特色。該平台已與麥高診所及 Dialpad 合作,展現在語音合成上的專業實力。
※ 摘要僅根據標題與說明
Open ASR Leaderboard 新增印度英語與印地語兩個全球南方語言測試集,透過詳細的地理、人口與裝置資訊,讓讀者能追蹤模型在不同區域與口音下的準確率差異。
探討了語音識別中「benchmark 最佳化」現象,即模型傾向於重現參考資料集中的錯誤或特定拼寫,而非準確聽寫。研究透過三項測試(共識分歧探測、掩碼數字測試、正字法切換測試)量化此問題,發現部分模型會根據參考資料的音訊特徵或拼寫習慣調整輸…