Build & Train a GLM-5.3-Flash Model From Scratch with Python
示範如何從零開始用 Python 訓練一個 2500 萬參數的 GLM-5.3 Flash 多模態語言模型,涵蓋分詞、預訓練與強化學習流程。
依發布時間
示範如何從零開始用 Python 訓練一個 2500 萬參數的 GLM-5.3 Flash 多模態語言模型,涵蓋分詞、預訓練與強化學習流程。
介紹 PewDiePie 訓練的 Ajax 模型,這是基於 Qwen 3.5 並移除安全限制後,透過 GPT Soul 輸出進行蒸餾訓練而成的。
由 Sebastian Raschka 講解如何從零開始用 Python 實現 GRPO 演算法,訓練小型推理模型。觀眾能學習 RLVR 的具體實作細節與訓練流程。
※ 摘要僅根據標題與說明
Lakshya A. Agrawal 介紹 GEPA,一種透過完整執行軌跡與文字反思來最佳化提示詞的高效方法,比傳統強化學習更省資源。
介紹 ScienceBuddy 如何透過模型與工具協同進化,提升科學 AI 代理的準確率。內容說明將人類專家修正轉化為可執行任務,並透過 GWAS 與文獻推理實現自我改進。
※ 摘要僅根據標題與說明
探討 AI 在網路安全、數學與 AI 研究本身的加速差異,並介紹 SPADE 與 Hawkeye 等工具如何自動生成訓練環境與最佳化 GPU 核心程式碼。最後也討論了關於 AI 是否應有權利、人類意識危機等哲學議題。
探討文字轉影像模型雖能生成逼真畫面,卻在人物身份一致性、高解析度與邊緣裝置運算上仍有挑戰。Fatih Porikli 介紹了利用強化學習最佳化訓練目標,以提升畫面可控性、消除偽影並實現高效本地生成。
Chelsea Finn 分享 Physical Intelligence 如何透過強化學習與大模型訓練,開發能自主長時間運作的一般目的機器人。
討論 GLM-5.2 模型訓練策略,指出其放棄 GRPO 改用 PPO 的決定值得關注,並分享作者對模型表現之外的洞見。適合對大模型訓練技術感興趣的開發者與研究者。
※ 摘要僅根據標題與說明
Cosine 創辦人 Alistair Pullen 與 Tim Scarfe 訪談,探討因美國出口管制導致 Fable 模型受限後,英國如何透過 Isambard 超級電腦與企業協作,以低成本訓練國有大型語言模型。
解析 Ornith-1 模型如何透過專業化訓練與動態控制架構,讓小型模型在效能上超越龐大對手。觀眾可了解其防止獎勵駭客機制與真實測試結果,掌握 AI 程式設計新趨勢。
※ 摘要僅根據標題與說明
介紹 Ornith 1.0 系列自架構編碼模型,能自動設計並執行任務指令碼。觀眾可學習模型如何利用強化學習訓練「自支撐」能力,以及如何在本地環境執行不同規模模型。
由 Sebastian Raschka 主講,分析 2026 年 AI 趨勢,重點在於從原始模型擴展轉向後訓練與推理技術。內容涵蓋自一致性、自最佳化等提升數學與編碼能力的推理方法,以及工具整合與代理工作流的實際應用。
Sebastian Raschka 與 Matt Turck 深入探討 2025 至 2026 年大型語言模型的演進,涵蓋架構選擇、RLVR 與 GRPO 強化學習技術、推理縮放策略及評估方法。
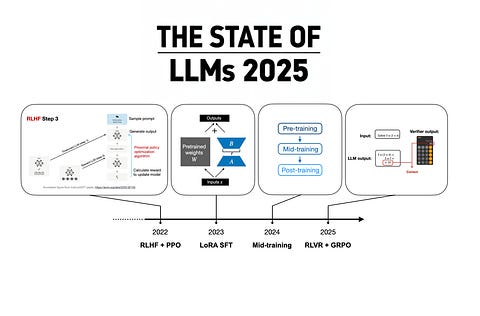
Sebastian Raschka 回顧 2025 年大型語言模型發展,重點分析 DeepSeek R1 帶來的推理模型突破與 RLVR 演算法。
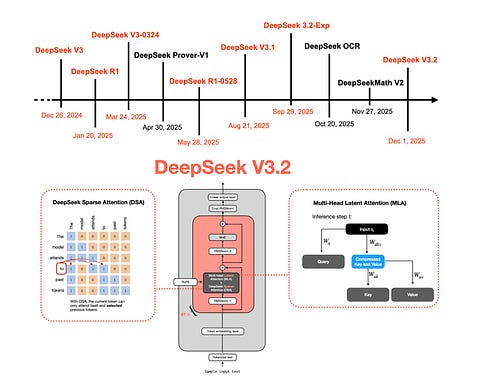
深入解析 DeepSeek V3.2 的架構演進,涵蓋稀疏注意力機制、自驗證訓練方法與 GRPO 最佳化細節,並對比其與 V3、R1 及 Qwen3 等模型的差異。讀者可掌握最新開源大模型的技術亮點與訓練策略。
依人氣
示範如何從零開始用 Python 訓練一個 2500 萬參數的 GLM-5.3 Flash 多模態語言模型,涵蓋分詞、預訓練與強化學習流程。
介紹 PewDiePie 訓練的 Ajax 模型,這是基於 Qwen 3.5 並移除安全限制後,透過 GPT Soul 輸出進行蒸餾訓練而成的。
Chelsea Finn 分享 Physical Intelligence 如何透過強化學習與大模型訓練,開發能自主長時間運作的一般目的機器人。
Lakshya A. Agrawal 介紹 GEPA,一種透過完整執行軌跡與文字反思來最佳化提示詞的高效方法,比傳統強化學習更省資源。
Sebastian Raschka 回顧 2025 年大型語言模型發展,重點分析 DeepSeek R1 帶來的推理模型突破與 RLVR 演算法。
深入解析 DeepSeek V3.2 的架構演進,涵蓋稀疏注意力機制、自驗證訓練方法與 GRPO 最佳化細節,並對比其與 V3、R1 及 Qwen3 等模型的差異。讀者可掌握最新開源大模型的技術亮點與訓練策略。
介紹 Ornith 1.0 系列自架構編碼模型,能自動設計並執行任務指令碼。觀眾可學習模型如何利用強化學習訓練「自支撐」能力,以及如何在本地環境執行不同規模模型。
討論 GLM-5.2 模型訓練策略,指出其放棄 GRPO 改用 PPO 的決定值得關注,並分享作者對模型表現之外的洞見。適合對大模型訓練技術感興趣的開發者與研究者。
※ 摘要僅根據標題與說明
探討文字轉影像模型雖能生成逼真畫面,卻在人物身份一致性、高解析度與邊緣裝置運算上仍有挑戰。Fatih Porikli 介紹了利用強化學習最佳化訓練目標,以提升畫面可控性、消除偽影並實現高效本地生成。
探討 AI 在網路安全、數學與 AI 研究本身的加速差異,並介紹 SPADE 與 Hawkeye 等工具如何自動生成訓練環境與最佳化 GPU 核心程式碼。最後也討論了關於 AI 是否應有權利、人類意識危機等哲學議題。