Open Models: Kimi K3, Qwen 3.8, Xi's WAIC Speech, Distillation, The Open-Closed Gap, and What's Next
Nathan Lambert 與 Florian Brand 討論開源模型的最新動態,涵蓋 Kimi K3、Qwen 3.8 及中國實驗室表現。他們分析開源模型在特定任務上的潛力、與封閉模型的差距,並預測未來模型發展趨勢與競爭格局。
8,844次觀看
23 筆內容提到
最近 7 天 0 筆(再前 7 天 0 筆)
也寫作:DeepSeek-V4、Deepseek V4
這一頁列的是「提到 DeepSeek V4」的內容(名稱由語言模型從內容裡整理),不一定整筆都在講它。只想追它的新內容:訂閱 RSS;想找標題裡就有它的:搜尋「DeepSeek V4」。
依發布時間
Nathan Lambert 與 Florian Brand 討論開源模型的最新動態,涵蓋 Kimi K3、Qwen 3.8 及中國實驗室表現。他們分析開源模型在特定任務上的潛力、與封閉模型的差距,並預測未來模型發展趨勢與競爭格局。
解析 DeepSeek-V4 的 DSpark 技術,說明其如何突破推論速度限制並最佳化計算資源。觀眾可了解該模型在實際部署中的工程最佳化策略與具體做法。
※ 摘要僅根據標題與說明
教導如何從零開始,使用 AI 程式設計與 EdgeOne Makers 開發一個「毒舌 AI 投資人」代理。觀眾將學習撰寫提示詞、部署技能並連線 DeepSeek V4 模型,以驗證副業想法。
※ 摘要僅根據標題與說明
DeepSeek V4 放棄傳統強化學習階段,改用十位專家教師進行線上政策精簡,透過混合注意力機制大幅降低百萬字元上下文成本。文章解析其架構細節、訓練策略與基準測試表現,並探討此方法對未來大型模型開發的影響。
深入解析 Nemotron 3 Ultra 模型的架構、訓練過程與後訓練策略,探討其如何利用多教師者政策蒸餾(MOPD)提升效能。
解析華為昇騰 950 系列如何透過系統級最佳化與 CANN 架構,解決 DeepSeek V4 等中國大模型的算力挑戰。觀眾能了解華為如何突破物理限制,建立不依賴輝達的自主算力生態。
※ 摘要僅根據標題與說明
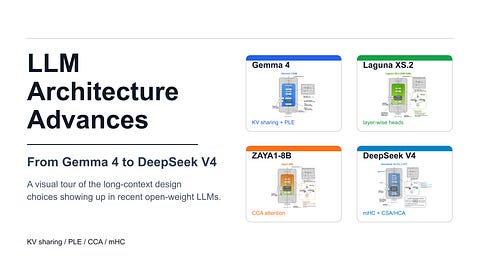
深入解析 Gemma 4、Laguna XS.2、ZAYA1-8B 與 DeepSeek V4 等最新開源大型語言模型的架構創新,重點探討 KV 共享、壓縮注意力與層級預算分配等技術。
探討 AI 代理在執行程式時,因使用 Bash 工具而造成的生產環境毀損風險,並提出五級安全架構。透過實測展示從依賴模型指令到建立白名單、甚至完全移除 Bash 工具的防護層級,讓工程師掌握如何防止 AI 誤操作。
介紹 Opus 4.7 與 GPT 5.5 構建的「驗證者代理」模式,讓編譯代理完成任務後,由另一代理自動驗證結果並提供反饋。觀眾能學習如何透過多代理協作提升程式碼品質,並將工程習慣模板化以增強系統信任度與可擴展性。
涵蓋 Mayo Clinic 利用 AI 提前三年篩檢胰臟癌的突破、Cursor SDK 與 Devin CLI 的開發者工具更新,以及 OpenAI GPT-5.5 模型中「小精靈」詞彙濫用的安全調查。
深入解析 DeepSeek V4 如何透過稀疏注意力機制降低成本,涵蓋分組查詢注意力、壓縮稀疏注意力等技術細節。觀眾能理解其架構原理並掌握模型訓練與部署的關鍵概念。
※ 摘要僅根據標題與說明
※ 摘要僅根據標題與說明
探討 DeepSeek V4 如何透過高詞元效率與架構創新,對 OpenAI、Anthropic 等閉源巨頭構成挑戰。兩位專家分析效率如何成為 AGI 的基礎,並討論非輝達晶片與混合部署對商業模式的衝擊。
訪談由 RadixArk 工程師與 UCLA 博士生,深入解析 DeepSeek V4 技術細節。內容涵蓋放棄 MLA 架構改用混合稀疏注意力、Muon 最佳化器、mHC 及 FP4 等工程創新,探討如何讓百萬上下文從理論走向實用,並分析…
探討 DeepSeek V4 發布後,為何由該公司而非騰訊、阿里主導華為昇騰的國產算力適配,並分析其雙軌策略:公開版維持 CUDA 生態以獲取全球開發者支援,而國產版則透過預留價格下降空間與融資籌措來站隊中國。
介紹 DeepSeek V4 模型如何透過壓縮注意力機制(CSA 與 HCA)大幅降低記憶體佔用。觀眾能了解長上下文處理的高效架構與關鍵技術細節。
※ 摘要僅根據標題與說明
透過訪談多位開發者、創業家與投資人,深入解析 DeepSeek V4 在工程最佳化、長上下文處理及成本效益上的優勢,同時指出其在工具呼叫穩定性與事實性知識上的不足,並提供適合程式設計、中文創作與長文分析的實際應用建議。
比較 DeepSeek V4 在程式設計任務上的表現,指出其成本僅為 GPT-5.5 的三分之一,並示範如何使用 Pi 程式設計套件。觀眾能了解最新程式設計代理模型的效能與價格優勢。
※ 摘要僅根據標題與說明
深入探討 GPT-5.5 如何以更低成本超越 Claude Opus 4.7,成為地表最強 AI,並分析其對企業與開發者的實際影響。
聚焦 AI 模型與智慧體基礎設施的集中爆發,涵蓋 GPT-5.5、DeepSeek V4、Kimi K2.6 等最新模型,並深入探討智慧體雲、Harness Engineering 與 MCP 協議等工程實踐。
探討大型語言模型與駕馭工程能否通往通用人工智慧,並分析世界模型如何補足對物理世界理解的不足。內容涵蓋 AI 詐騙防護、開發者體驗痛點,以及 Yann LeCun 提出的 JEPA 架構與 LeWorldModel 新突破,最後預測未來可能…
分析 GPT 5.5、DeepSeek V4 等最新模型,並探討計算資源競爭與自改進機制。觀眾可了解當前 AI 發展趨勢與技術比較。
※ 摘要僅根據標題與說明
深入解析 Gemini 3.1 Pro 與 Claude 系列新版本的表現,探討後訓練階段如何導致模型在不同領域專精,並質疑傳統基準測試的有效性。內容涵蓋模型在程式設計、邏輯推理及幻覺問題上的實際表現,指出基準測試可能存在的偏誤與捷徑。
依人氣
※ 摘要僅根據標題與說明
DeepSeek V4 放棄傳統強化學習階段,改用十位專家教師進行線上政策精簡,透過混合注意力機制大幅降低百萬字元上下文成本。文章解析其架構細節、訓練策略與基準測試表現,並探討此方法對未來大型模型開發的影響。
深入解析 Gemma 4、Laguna XS.2、ZAYA1-8B 與 DeepSeek V4 等最新開源大型語言模型的架構創新,重點探討 KV 共享、壓縮注意力與層級預算分配等技術。
聚焦 AI 模型與智慧體基礎設施的集中爆發,涵蓋 GPT-5.5、DeepSeek V4、Kimi K2.6 等最新模型,並深入探討智慧體雲、Harness Engineering 與 MCP 協議等工程實踐。
深入解析 Nemotron 3 Ultra 模型的架構、訓練過程與後訓練策略,探討其如何利用多教師者政策蒸餾(MOPD)提升效能。
透過訪談多位開發者、創業家與投資人,深入解析 DeepSeek V4 在工程最佳化、長上下文處理及成本效益上的優勢,同時指出其在工具呼叫穩定性與事實性知識上的不足,並提供適合程式設計、中文創作與長文分析的實際應用建議。
探討 DeepSeek V4 如何透過高詞元效率與架構創新,對 OpenAI、Anthropic 等閉源巨頭構成挑戰。兩位專家分析效率如何成為 AGI 的基礎,並討論非輝達晶片與混合部署對商業模式的衝擊。
分析 GPT 5.5、DeepSeek V4 等最新模型,並探討計算資源競爭與自改進機制。觀眾可了解當前 AI 發展趨勢與技術比較。
※ 摘要僅根據標題與說明
教導如何從零開始,使用 AI 程式設計與 EdgeOne Makers 開發一個「毒舌 AI 投資人」代理。觀眾將學習撰寫提示詞、部署技能並連線 DeepSeek V4 模型,以驗證副業想法。
※ 摘要僅根據標題與說明
解析 DeepSeek-V4 的 DSpark 技術,說明其如何突破推論速度限制並最佳化計算資源。觀眾可了解該模型在實際部署中的工程最佳化策略與具體做法。
※ 摘要僅根據標題與說明