写在 HAMi 晋升 CNCF Incubating 之后:AI 时代,开源社区正在从代码共同体走向共识网络
探討 AI 如何改變開源社群的生產模式,指出當程式碼成本下降後,稀缺資源從程式碼轉向技術共識與社群治理。透過 HAMi 晉升 CNCF Incubating 的案例,說明建立信任、判斷問題價值及選擇技術路線是 AI 難以替代的核心能力,未…
依人氣
探討 AI 如何改變開源社群的生產模式,指出當程式碼成本下降後,稀缺資源從程式碼轉向技術共識與社群治理。透過 HAMi 晉升 CNCF Incubating 的案例,說明建立信任、判斷問題價值及選擇技術路線是 AI 難以替代的核心能力,未…
回顧 KubeCon China 2026 上海大會,探討雲原生如何從舞台中央下沉為支撐 AI 的基礎設施底座。內容分析 GPU 排程、異構算力管理與 Agent 協議對 Kubernetes 架構帶來的挑戰與演進方向。
作者正式加入 Dynamia 密瓜智慧擔任開源生態 VP,專注於 AI 原生基礎設施建設。文章探討了算力治理如何將 GPU 從單純的硬體消耗轉化為可計量與排程的核心資產,並介紹了公司主導的 HAMi 開源專案及其在異構算力虛擬化方面的應用。
指出單純追求 GPU 利用率數字可能產生誤導,因為 GPU 忙碌不代表真正產出價值。作者提出應將目標從「GPU 利用率」升級為「有效 GPU 小時」,並強調需關注儲存 I/O、資料通路等底層因素,避免資源碎片化導致系統空轉。
探討 Agent-Driven Development(ADD)時代,Spec 如何從說明文件轉變為可治理的核心資產。文章指出,隨著 AI 實現成本下降,工程治理與一致性成本上升,Spec 成為定義邊界、確保意圖守恆的關鍵控制平面。
AI 原生全景圖獨立上線,收錄 600 多個開源專案並提供自動更新的評分機制,幫助使用者篩選活躍且高品質的 AI 工具。文章介紹了該平台的八大分類、Skill 搜尋功能以及技術架構,讓讀者快速掌握當前 AI 領域的優質資源。
探討 AI 如何從應用技術演變為像電力與網際網路般的新基礎設施,並分析 NVIDIA GTC 2026 所釋放關於 AI 晶片、資料中心與智慧體的趨勢。讀者可了解 AI 原生基礎設施的定義、架構演進及未來競爭焦點。
分析 Kubernetes 如何演變為 AI 時代的 GPU 控制面,透過 HAMi v2.9 與 DRA 機制,解決多廠商異構算力排程與細粒度資源隔離問題。讀者可理解下一代 AI 基礎設施的架構趨勢與技術演進方向。
對比秒言、智譜與閃電說三款 AI 語音輸入法的速度、穩定性與命令能力,分析秒言在工程效率上的優勢、智譜因繫結套餐的實惠性,以及閃電說的端側路線。讀者可了解各產品差異,掌握選擇適合開發者工作流的語音工具。
依發布時間
探討大模型時代 GPU 切分技術的必要性,並介紹 TypeSafe AI 推出的 Jev 系統一模型,該模型專注於快速分類與判斷而非自由對話。透過實作範例與架構分析,說明將判斷任務從大模型中分離,能提升效能並最佳化資源利用。
回顧 KubeCon China 2026 上海大會,探討雲原生如何從舞台中央下沉為支撐 AI 的基礎設施底座。內容分析 GPU 排程、異構算力管理與 Agent 協議對 Kubernetes 架構帶來的挑戰與演進方向。
深入解析 GPU 排程中的三個維度,並重點說明 HAMi v2.10 新增的 mutex 策略。透過在 kind 環境中模擬實驗,作者闡明 mutex 的真實語義是要求目標 GPU 卡上「零租戶」,而非僅與其他 mutex Pod 互斥…
探討 GPU 共享如何從單純的資源分配走向具備強制隔離與可驗證的治理。透過分析 GPU 軟體架構的五層結構,釐清 GPU Operator、KAI Scheduler 與 HAMi Core 各自在排程、分配與執行隔離中的職責。
探討 AI 如何改變開源社群的生產模式,指出當程式碼成本下降後,稀缺資源從程式碼轉向技術共識與社群治理。透過 HAMi 晉升 CNCF Incubating 的案例,說明建立信任、判斷問題價值及選擇技術路線是 AI 難以替代的核心能力,未…
探討 Olares 如何將 Kubernetes 與 HAMi 整合,打造端側 AI 工作站,解決單一機器上多工並行時的 GPU 資源衝突問題。
作者透過安吉竹編與荷蘭風車的觀察,連結人類最早的大規模編碼方式與工業化起點,探討紡織業如何成為現代文明的共同源頭。文章梳理了英國、日本、韓國及中國從紡織起步的歷史路徑,並指出編織邏輯與今日 AI 的計算本質存在深層關聯。
用 Kubernetes 老兵熟悉的概念,解釋 AI 訓練與推理為何必須依賴 GPU,並對比 CPU 的差異。讀者能理解 Tensor Core、HBM、KV Cache 等專有名詞,掌握 GPU 資源排程與異構叢集的基礎知識。
指出單純追求 GPU 利用率數字可能產生誤導,因為 GPU 忙碌不代表真正產出價值。作者提出應將目標從「GPU 利用率」升級為「有效 GPU 小時」,並強調需關注儲存 I/O、資料通路等底層因素,避免資源碎片化導致系統空轉。
深入解讀 Hesham ElBakoury 關於 Agentic AI 基礎設施可靠性的論文,指出 Agent 本質是長期執行的分散式狀態機,需將容錯、恢復與可觀測性提升為架構一等公民。
分享個人 AI 基礎設施架構,整合 ChatGPT、GLM-5.1、OpenClaw 與 Obsidian 等工具,建立思考、執行與記憶的協同系統。
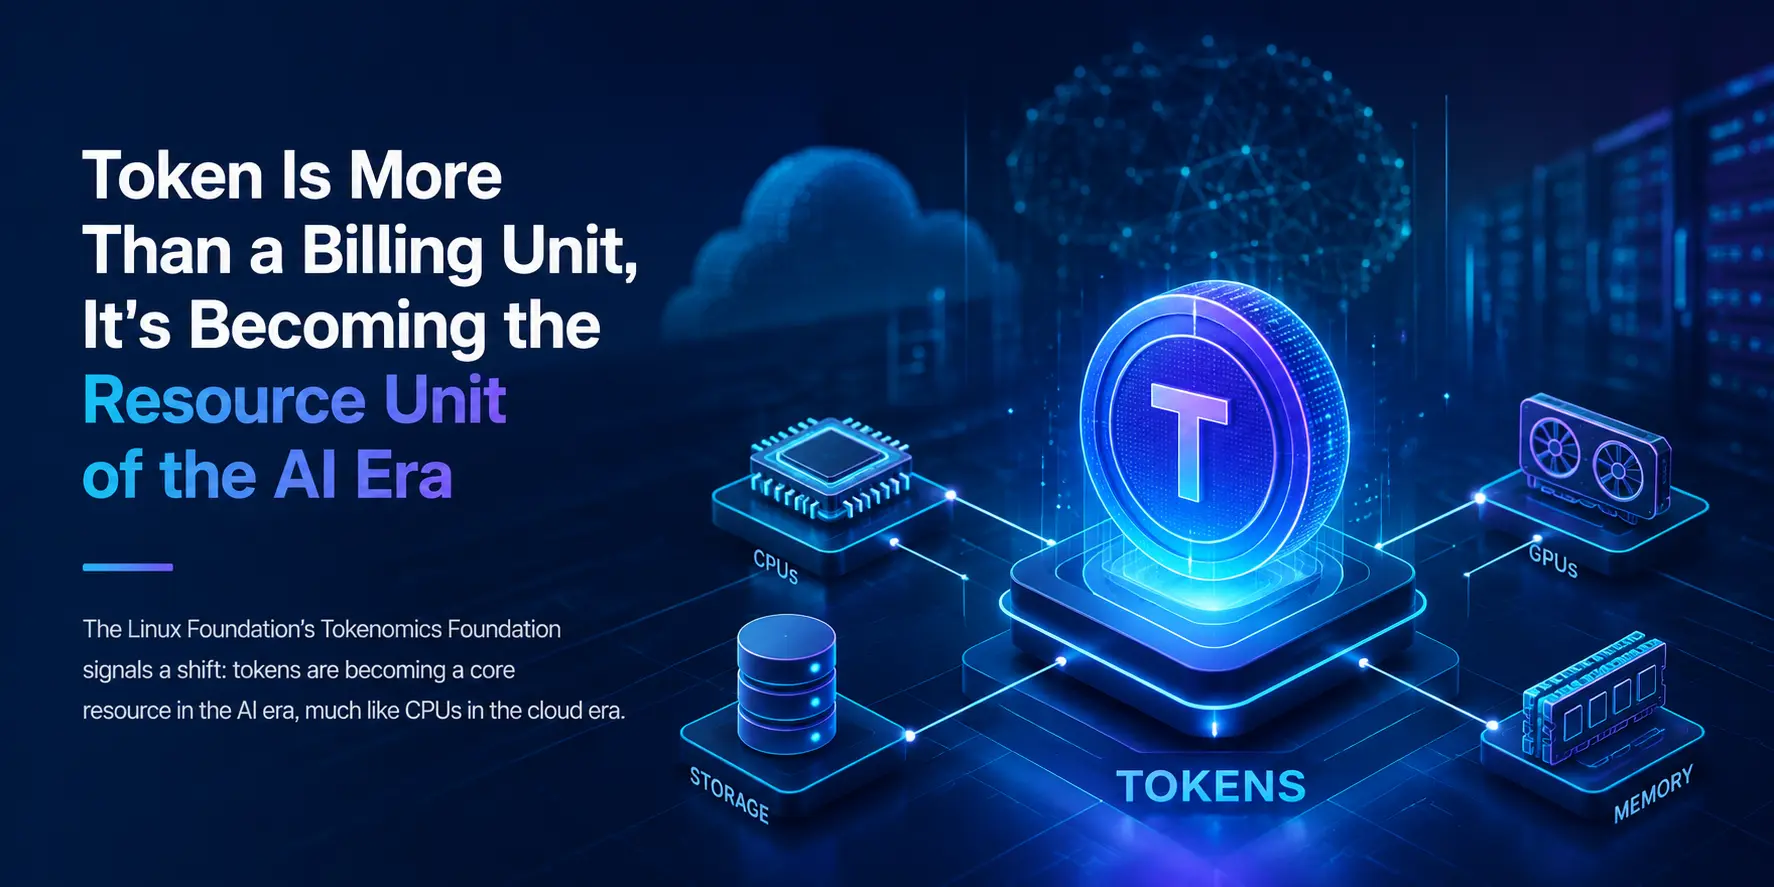
探討 Linux Foundation 成立 Tokenomics Foundation 的意義,指出 Token 正從計費單位轉變為 AI 時代的新資源與產出單位。
AI 原生全景圖獨立上線,收錄 600 多個開源專案並提供自動更新的評分機制,幫助使用者篩選活躍且高品質的 AI 工具。文章介紹了該平台的八大分類、Skill 搜尋功能以及技術架構,讓讀者快速掌握當前 AI 領域的優質資源。
分析 Kubernetes 如何演變為 AI 時代的 GPU 控制面,透過 HAMi v2.9 與 DRA 機制,解決多廠商異構算力排程與細粒度資源隔離問題。讀者可理解下一代 AI 基礎設施的架構趨勢與技術演進方向。
探討 Kubernetes 在 AI 浪潮下面臨的挑戰與轉型,指出其正從通用基礎設施演變為 AI 工作負載的排程核心。內容涵蓋 GPU 資源管理、推理系統標準化及模型交付等關鍵議題,分析 Kubernetes 如何被 AI 重新定義。
探討 Token 在中文語境下的翻譯爭議,分析從「模元」到「智元」再到「詞元」的背後邏輯。作者指出 Token 本質是工程抽象而非固定實體,因此「詞元」作為最穩健的標準化選擇勝出,而「智元」則保留在敘事層面。
記錄作者在 KubeCon Europe 2026 的觀察,指出 Kubernetes 正從雲端基礎設施轉向 AI 基礎設施,重點討論 GPU 資源管理與 LLM 執行的整合。
探討 AI 如何從應用技術演變為像電力與網際網路般的新基礎設施,並分析 NVIDIA GTC 2026 所釋放關於 AI 晶片、資料中心與智慧體的趨勢。讀者可了解 AI 原生基礎設施的定義、架構演進及未來競爭焦點。
解析 GPU 從私有實現轉向開放排程的結構性變革,重點在於 DRA 與 CDI 標準如何讓資源契約可治理。透過 CNCF 生產案例與智譜 GLM-5 實踐,說明開放排程如何解決多雲環境下的資源錯配與異構挑戰。
作者將 44 個 AI 教育資源從生產工具列表中移除,整理成包含 Awesome 列表、課程、Cookbook 與指南的精選合集。讀者可透過此資源庫系統性地學習 AI 基礎、掌握大型語言模型應用並獲取實作範例。
致敬支撐現代 AI 革命的大資料與雲原生基礎設施,如 Hadoop、Kafka、Spark 與 Kubernetes。文章說明這些傳統開源專案如何解決規模化問題,為大型語言模型與 AI 智慧體奠定運算、儲存與部署基礎。
分享加入 Dynamia 密瓜智慧一個月後的觀察,闡述 AI 原生基礎設施(AI Native Infra)的核心在於算力治理而非單純模型最佳化。
分享真實使用智譜 GLM 4.7、Claude Sonnet 4.5 等多模型並行程式設計的經驗,強調根據場景分工選擇工具。讀者可學習如何組建適合自己的 Vibe Coding 工作流,並了解不同模型在成本與效能上的平衡策略。
探討 Agent-Driven Development(ADD)時代,Spec 如何從說明文件轉變為可治理的核心資產。文章指出,隨著 AI 實現成本下降,工程治理與一致性成本上升,Spec 成為定義邊界、確保意圖守恆的關鍵控制平面。
對比秒言、智譜與閃電說三款 AI 語音輸入法的速度、穩定性與命令能力,分析秒言在工程效率上的優勢、智譜因繫結套餐的實惠性,以及閃電說的端側路線。讀者可了解各產品差異,掌握選擇適合開發者工作流的語音工具。
透過對比蘋果地圖中中國與全球其他地區空氣品質資料的呈現差異,探討技術標準與資料主權如何影響 AI 開源路徑。作者分析全球在公共資料開放上的三種不同策略,並指出 AI 競爭的關鍵已從模型權重轉向基礎設施與規則層,呼籲中國在保持治理底線的同時…
作者正式加入 Dynamia 密瓜智慧擔任開源生態 VP,專注於 AI 原生基礎設施建設。文章探討了算力治理如何將 GPU 從單純的硬體消耗轉化為可計量與排程的核心資產,並介紹了公司主導的 HAMi 開源專案及其在異構算力虛擬化方面的應用。